क्या गंभीर स्थानीय LLM काम के लिए 16GB VRAM पर्याप्त है?
Table of Contents
16GB की समर्पित GPU मेमोरी गंभीर स्थानीय LLM काम के लिए पर्याप्त है, जब मॉडल, कॉन्टेक्स्ट और रनटाइम साथ फिट हों। वेट लोड होना केवल पहली शर्त पूरी करता है। उपयोगी सेटअप के लिए चल रही बातचीत के लिए पर्याप्त मेमोरी और कार्य पूरा करने की पर्याप्त गति भी चाहिए।
एकल उपयोगकर्ता के कोडिंग या दस्तावेज़ वर्कफ़्लो का बजट बनाने के लिए Qwen3.8 27B को उदाहरण मानें। पहले अपने कार्य के लिए आवश्यक कॉन्टेक्स्ट चुनें, फिर बचे हुए मेमोरी बजट में फिट होने वाले वेट और रनटाइम सेटिंग चुनें। हार्डवेयर स्पेसिफिकेशन और मॉडल स्रोत 7 अक्टूबर 2026 को जाँचे गए थे।
मुख्य बातें
- क्वांटाइजेशन चुनने से पहले कॉन्टेक्स्ट के लिए मेमोरी बचाएँ।
- प्रॉम्प्ट प्रोसेसिंग को आउटपुट स्पीड से अलग मापें।
- अप्रयुक्त विज़न सपोर्ट बंद करें और 8-बिट KV कैश जाँचें।
- सटीक GPU, बैकएंड, मॉडल फ़ाइल और प्रॉम्प्ट लंबाई की तुलना करें।
- अपने वर्कलोड और प्रोवाइडर बिल के आधार पर स्वामित्व बचत निकालें।
बजट अभ्यास के लिए रनटाइम का मेमोरी लॉग, मॉडल फ़ाइल का सटीक नाम और प्रतिनिधि कार्य चाहिए। सेटअप और परिणाम रिकॉर्ड करने के लिए लगभग 20 मिनट रखें, इसके बाद इन्फरेंस समय अलग है। कठिनाई मध्यम है।
मेमोरी को काम से मिलाएँ
16GB ऐसे वर्कलोड के लिए उपयुक्त है जिसमें मॉडल वेट, सक्रिय कॉन्टेक्स्ट और अस्थायी आवंटन उपलब्ध GPU मेमोरी के भीतर रहें। आवश्यक कॉन्टेक्स्ट कार्य पर निर्भर है। छोटा दस्तावेज़ सारांश और दर्जनों फ़ाइल पढ़ने वाला कोडिंग एजेंट अलग बजट माँगते हैं।
| वर्कलोड | पहला आकार-निर्धारण प्रश्न |
|---|---|
| छोटी चैट या ड्राफ्टिंग | क्या मॉडल आपकी गुणवत्ता सीमा पूरी करता है? |
| दस्तावेज़ विश्लेषण | क्या स्रोत टेक्स्ट और उत्तर साथ फिट होते हैं? |
| कोडिंग एजेंट | फ़ाइलें और टूल परिणाम कितना कॉन्टेक्स्ट लेते हैं? |
| समानांतर अनुरोध | हर सक्रिय सत्र को कितना कैश चाहिए? |
कॉन्फ़िगर की गई विंडो और उपयोग में आई विंडो अलग होती हैं। 64K सीमा और छोटे प्रॉम्प्ट वाला बेंचमार्क बातचीत के 55K टोकन बाद की जनरेशन नहीं मापता। हार्डवेयर चुनने से पहले अपेक्षित सत्र लंबाई के पास परीक्षण करें।
मॉडल क्यों फिट होता है
क्वांटाइजेशन वेट को कम बिट में स्टोर करता है। Bartowski की Qwen3.8 27B फ़ाइल तालिका Q4_K_M को 17.44 GB बताती है। यह रनटाइम मेमोरी से पहले ही 16 GiB डिवाइस के लगभग 17.18 अरब बाइट से अधिक है।
ISTA-DASLab का GSQ-RCO मॉडल कार्ड IQ3_S को 11.8 GB बताता है। इसकी विधि आकार बजट के भीतर अलग-अलग टेंसर को अलग सटीकता देती है। वैकल्पिक MTP संस्करण लगभग 0.35 GB जोड़ता है, जबकि विज़न प्रोजेक्टर लगभग 0.9 GB जोड़ता है।
| प्रकाशित बेंचमार्क | BF16 / IQ3_S स्कोर |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
लैब इस ऑपरेटिंग पॉइंट को “task-lossless” कहती है। ये चुने हुए परिणाम सीमित तुलना का समर्थन करते हैं। वे समान उत्तर, समान लंबे-कॉन्टेक्स्ट रिट्रीवल या आपके कोडिंग कार्यों में समान विश्वसनीयता सिद्ध नहीं करते। अपने स्वीकृति मानदंड के विरुद्ध संकुचित मॉडल जाँचें।
कैश गिनें
KV कैश पहले प्रोसेस किए गए टोकन की attention keys और values रखता है। प्रॉम्प्ट, टूल आउटपुट और जनरेट किए गए उत्तर कॉन्टेक्स्ट लेते हैं। कुछ रनटाइम स्टार्टअप पर कैश क्षमता आवंटित करते हैं, इसलिए दिखाई गई मेमोरी हर संदेश के साथ बढ़ना आवश्यक नहीं है।
Qwen का कॉन्फ़िगरेशन 64 लेयर, हर चौथी लेयर पर full attention, चार KV heads और 256 की head dimension बताता है। उन 16 full-attention लेयर के लिए गणना की गई FP16 कैश लागत है:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
यह गणना recurrent state, alignment, temporary buffers और speculative decoding allocations को शामिल नहीं करती। अन्य architectures के लिए अलग गणना चाहिए।
| उपयोग में आए टोकन | FP16 full-attention cache |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
यहाँ KiB और GiB 1024 की घातों का उपयोग करते हैं। मॉडल डाउनलोड आकार decimal GB में हैं। इकाइयाँ मिलाने से बचा हुआ बजट गलत दिखता है।
उपलब्ध कॉन्टेक्स्ट बजट तय करें
दो सेटिंग लंबी टेक्स्ट सत्रों के लिए मेमोरी मुक्त करती हैं: अप्रयुक्त विज़न प्रोजेक्टर हटाएँ और कैश सटीकता घटाएँ। अपने लोडेड मॉडल और रनटाइम आवंटनों के संदर्भ में प्रभाव निकालें।
यह उदाहरण उपयोग करें। हर आवंटन decimal GB में है। नीचे का 1.0 GB रिज़र्व योजना की धारणा है, सार्वभौमिक रनटाइम डिफ़ॉल्ट नहीं।
| आवंटन | Vision on / vision off |
|---|---|
| Physical 16 GiB capacity | 17.180 / 17.180 GB |
| Model weights | 11.800 / 11.800 GB |
| Optional MTP head | 0.350 / 0.350 GB |
| Vision projector estimate | 0.930 / 0 GB |
| Assumed other allocations | 1.000 / 1.000 GB |
| Left for growing cache | 3.100 / 4.030 GB |
65,536 bytes प्रति टोकन पर 3.100 GB लगभग 47,300 टोकन रखते हैं। Vision बंद होने पर आदर्श 8-bit storage 32,768 bytes प्रति टोकन लेगा और लगभग 123,000 टोकन रखेगा।
वास्तविक q8_0 storage में block scales शामिल होते हैं। 32 values के लिए 34 bytes पर इस उदाहरण को लगभग 34,816 bytes प्रति टोकन चाहिए, इसलिए अनुमान लगभग 115,700 तक घटता है। अतिरिक्त आवंटन परिणाम को और घटाते हैं। इसलिए इन धारणाओं के तहत लगभग 110K एक संभव योजना परिणाम है, गारंटीकृत सेटिंग नहीं।
बचा हुआ कॉन्टेक्स्ट input और output दोनों के लिए होना चाहिए। 65,536-token विंडो, उदाहरण के 30,000-token शुरुआती प्रॉम्प्ट और 8,192-token output allowance के साथ फ़ाइलों, टूल परिणामों और बातचीत के लिए 27,344 टोकन बचते हैं। शुरुआती प्रॉम्प्ट बजट उदाहरण है। अपने टूल और निर्देश मापें।
जाँचने योग्य सेटिंग
llama.cpp server documentation key और value cache types, automatic projector loading और parallel slots अलग-अलग बताता है। केवल टेक्स्ट वाले काम में vision बंद, दोनों cache types के लिए q8_0 और एक slot जाँचें। पहले छोटा कॉन्टेक्स्ट रखें।
कॉन्टेक्स्ट बढ़ाने से पहले मिले आवंटन लिखें। Cache quantization के लिए चुने हुए architecture और backend का support चाहिए। Precision बदलने के बाद उत्तर गुणवत्ता जाँचें। तुलना के लिए काम करने वाली configuration रखें।
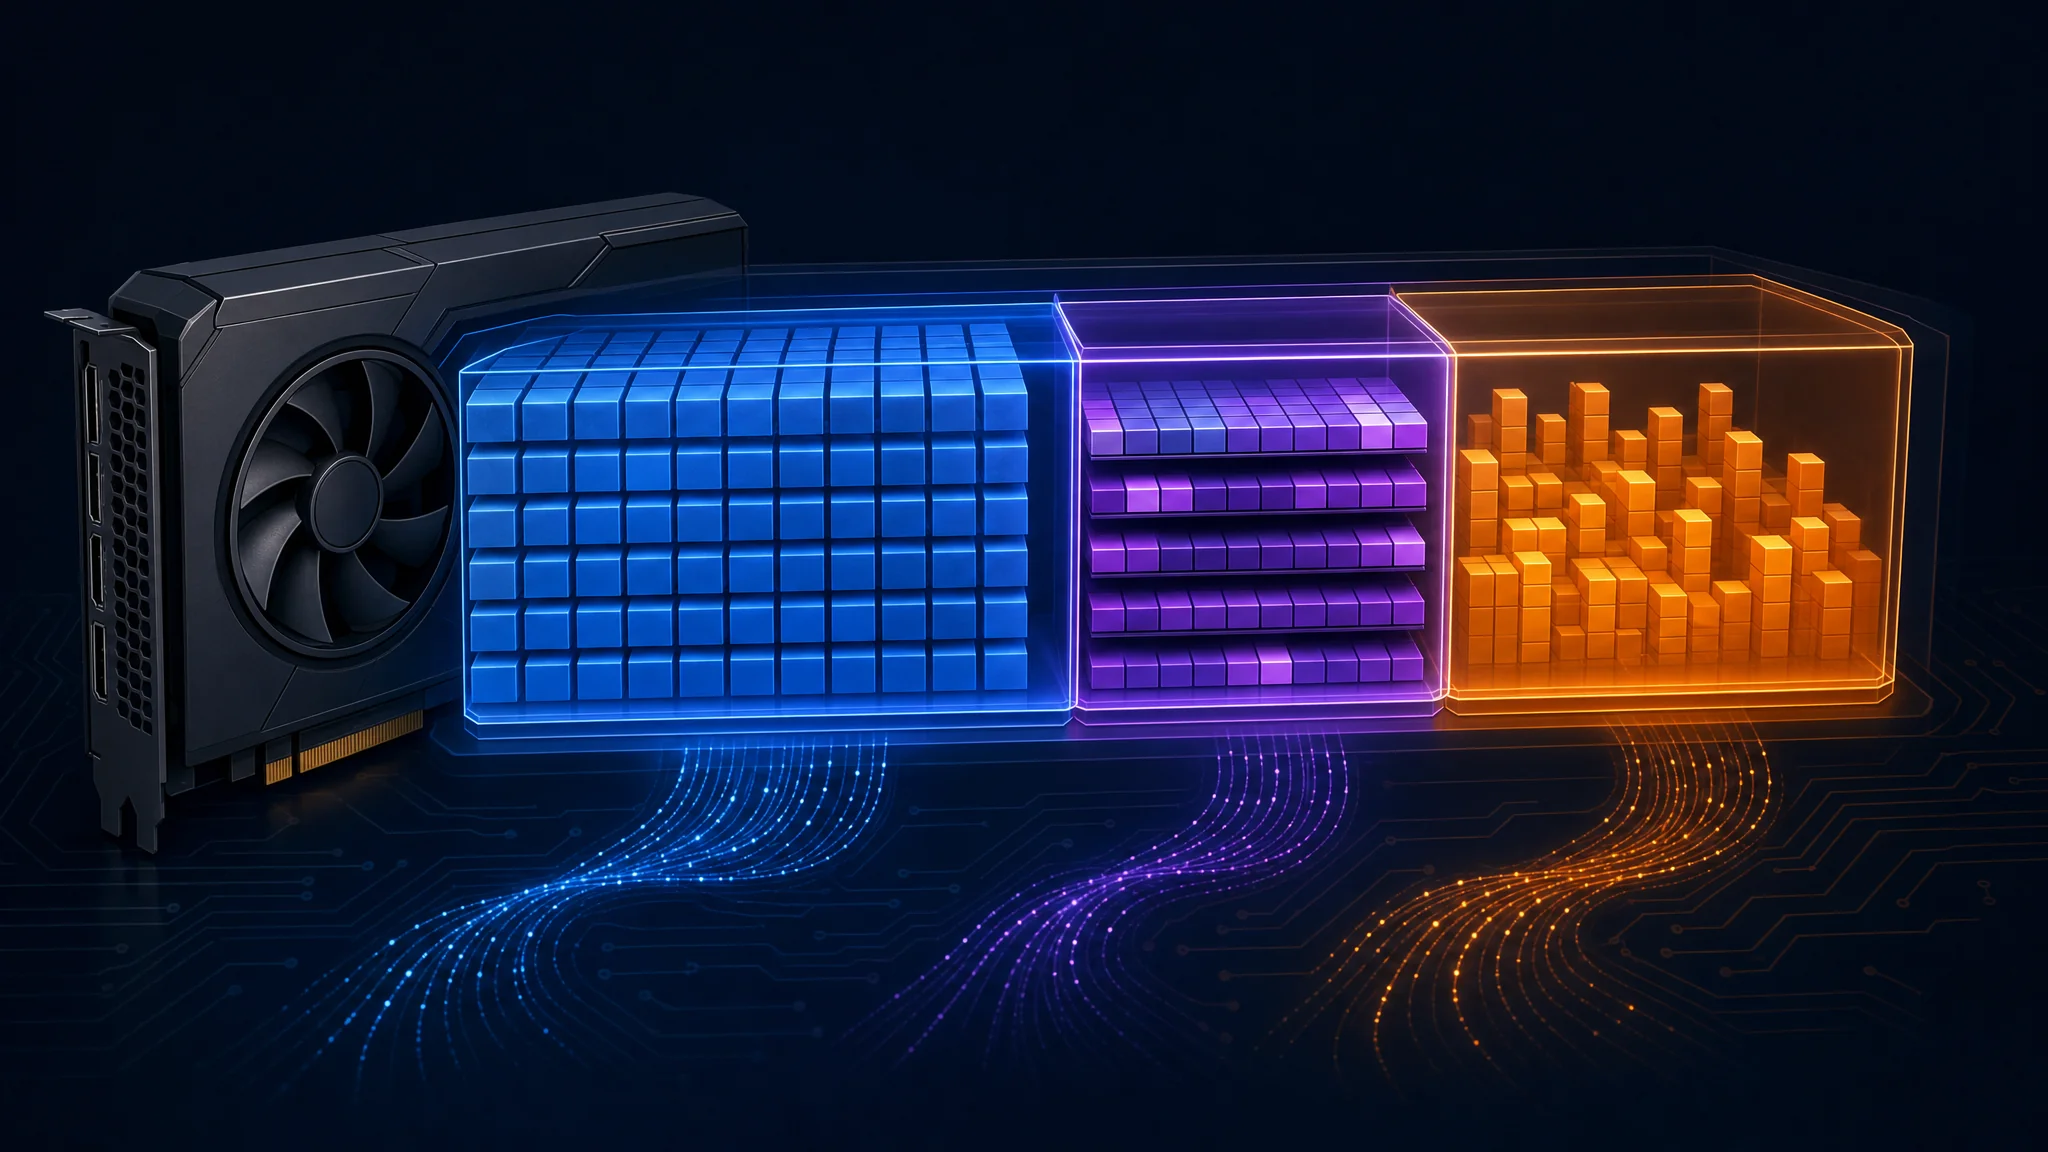
नीला weights, बैंगनी context cache और नारंगी runtime allocations दिखाता है। आकार illustrative हैं
गति अलग क्यों होती है
16GB का लेबल capacity बताता है। Throughput memory bandwidth, compute kernels, active context, offload, batching और speculative decoding पर भी निर्भर करता है।
| कारण | क्या जाँचें |
|---|---|
| CPU या RAM offload | Loaded layer placement और cache location |
| Long context | Measurement के समय occupied tokens |
| Backend differences | Runtime commit, driver और kernel path |
| Speculative decoding | Accepted drafts और extra allocations |
एक-एक token generate करने वाले dense model के लिए memory bandwidth को resident weight bytes से भाग देने पर rough bandwidth-only estimate मिलता है। 448 GB/s और 11.8 GB weights पर quotient लगभग 38 tokens प्रति सेकंड है। Cache reads और computation अतिरिक्त काम जोड़ते हैं, जबकि speculative decoding और batching assumptions बदलते हैं।
इस quotient को universal upper bound न मानें। Higher reported output rate benchmark को अपने आप गलत सिद्ध नहीं करता। जाँचें कि target-model pass ने कई draft tokens स्वीकार किए थे या नहीं।
Multi-token prediction, या MTP, को compatible model और runtime चाहिए। Short और long occupied context पर enabled तथा disabled runs की तुलना करें। Extra weights और draft state memory लेते हैं, पर 32K tokens के बाद MTP बंद करने का कोई universal rule नहीं है।
पहला उत्तर मापें
Prefill generation से पहले prompt process करता है। Decode answer बनाता है। जब task बड़े uncached prompt से शुरू होता है, तेज decode result slow first response छिपा सकता है।
Prompt-processing time का अनुमान लगाने के लिए uncached prompt tokens को measured prefill throughput से भाग दें। नए 30,000-token prompt पर दो illustrative rates ये waits देते हैं:
| Example prompt rate | Calculated processing time |
|---|---|
| 750 tokens/s | 40 seconds |
| 150 tokens/s | 200 seconds |
ये examples processing time बताते हैं और model loading तथा request overhead को छोड़ते हैं। Prompt length, batch size, model format और backend measured rate को बदलते हैं।
Cold request और reusable prefix वाली continuation को अलग-अलग मापें। Prefix reuse repeated input के कुछ हिस्से को फिर process करने से बचाता है। Time to first token को decode rate और total task duration के साथ रिकॉर्ड करें।
पूरे GPU setup की तुलना करें
Purchase price, usable memory, bandwidth और software path को साथ तुलना करें। सस्ता card अपना लाभ खो देता है यदि workload unsupported features माँगता है या latency target से अधिक समय लेता है।
| 16GB desktop card | Memory bandwidth |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
AMD के RX 9070 specifications और RX 9070 XT specifications 16GB capacity और up-to-640 GB/s bandwidth की पुष्टि करते हैं। 640 और 448 की तुलना लगभग 43% अधिक theoretical bandwidth देती है। इन specifications से 43% inference improvement सिद्ध नहीं होता।
अपने intended model और backend वाले benchmarks चुनें। Short prompts और sustained generation के लिए decode performance को अधिक महत्व दें। Repository analysis में cold prefill, long-context speed और successful task completion को प्राथमिकता दें। किसी vendor को खरीदने से पहले software availability जाँचें।
Mac और laptop labels
16GB Apple silicon Mac CPU, GPU, operating system और applications के बीच memory साझा करता है। Discrete 16GB GPU में system RAM के साथ dedicated video memory होती है। ये capacities equivalent model budgets नहीं बतातीं।
Apple recommended GPU working-set size देता है। Runtime की reported allowance और system memory pressure जाँचें। macOS और अन्य applications के लिए जगह छोड़ें, पूरे shared pool को inference के लिए budget न करें।
Laptops में manufacturer का exact SKU, dedicated memory, GPU power limit और cooling जाँचें। NVIDIA RTX 5060 family page desktop RTX 5060 Ti memory variants सूचीबद्ध करता है। Family name अकेले 16GB सिद्ध नहीं करता, और desktop results laptop throughput सिद्ध नहीं करते।
क्या ownership लाभ देती है?
Ownership तब वित्तीय रूप से लाभ देती है जब बचने वाले hosting charges operating costs से अधिक हों और hardware purchase की भरपाई करें। Output-only example से शुरू करें: $789 card, generation में 35 output tokens/s, 180W, $0.18/kWh electricity और hosted output tokens के लिए $2.95 प्रति million। ये illustrative inputs हैं। इन्हें purchase quote, measured power, electricity rate और provider pricing से बदलें।
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
हर दिन आठ घंटे uninterrupted generation पर यही गणना लगभग 291 दिन लेती है। Assistant खुला रखने के आठ घंटे और tokens generate करने के आठ घंटे अलग हैं।
Hosted output price $0.16 प्रति million होने पर इस scenario में local electricity hosting से पहले ही महँगी है। इन assumptions के तहत output-only break-even point positive नहीं है।
चुने हुए provider की current OpenRouter model pricing उपयोग करें, जिसमें input और cached-input charges शामिल हों। Prefill सहित whole-system energy मापें। Upgrades, idle energy, maintenance और expected resale value जोड़ें। Accepted work की तुलना करें, क्योंकि retries और quality differences cost per task बदलते हैं।
मेमोरी कब बढ़ाएँ
16GB से आगे तब जाएँ जब measured workload acceptable quality और latency पर available context से अधिक हो। Daily long agent sessions, concurrent requests या higher-precision weights बड़ी capacity को उपयोगी बनाते हैं।
दो 16GB cards को explicit runtime support चाहिए। वे transparent 32GB allocation नहीं बनते। हर device को buffers चाहिए और communication host interconnect का उपयोग करता है।
| Split strategy | Main tradeoff |
|---|---|
| Layer split | Different layers occupy different devices |
| Tensor or row split | Work within layers adds communication |
| CPU plus GPU | More capacity with a different latency profile |
दूसरा card तब विचार योग्य है जब motherboard, power supply, cooling और backend पहले से plan support करते हों। Complete system cost की तुलना larger single GPU से करें। 32GB Qwen hardware guide इन alternatives को cover करती है।
समस्या-समाधान और अगले कदम
Loading fail हो तो context घटाएँ और allocations जाँचें। Session में speed घटे तो occupied context और CPU offload जाँचें। First response रुकता हो तो cold prefill मापें। Compression के बाद tool use टूटे तो same task को higher-precision model के साथ compare करें।
Normal instructions, files और tool outputs वाला repeatable test बचाएँ। Model revision, runtime version, cache precision, occupied context, peak memory, first-token latency, decode speed और task pass रिकॉर्ड करें। Longest expected session के पास फिर परीक्षण करें।
छोटे alternatives की तुलना के लिए local model and context guide उपयोग करें। Quality requirements पूरा करने वाला सबसे छोटा model चुनें, फिर complete task के लिए पर्याप्त memory reserve करें। इन conditions में 16GB workstation के लिए उपयोगी target है।
Related Posts