हमारे हाइब्रिड एजेंटिक AI फ्लीट के भीतर: Hermes, LiteLLM और Tailscale

Table of Contents
हमने अनुरोध के अनुसार स्थानीय GPU संसाधन देने वाला फ्लीट तैनात किया और उसका हाइब्रिड नियंत्रण तल बनाया। सत्यापित मार्ग LiteLLM से शुरू होता है, मॉडल पूल चुनता है और एक समय में एक GPU पर स्थानीय मॉडल लोड करता है। Hermes की tier policy प्रस्तावित है और Tailscale Aperture का configuration artifact अगले integration test के लिए तैयार है। दोनों में से किसी को भी एक संपूर्ण end-to-end मार्ग का हिस्सा होने के रूप में सत्यापित नहीं किया गया।
निष्क्रिय कार्ड Pearl माइन करते हैं। AI अनुरोध केवल lease पर लिए गए कार्ड की माइनिंग रोकता है, अनुरोध पूरा करता है, मॉडल unload करता है और कार्ड को miner में वापस कर देता है।
मुख्य बातें
- T0 से T2 महंगे या कठिन काम संभालते हैं। ये मार्ग hosted frontier मॉडल और क्रमबद्ध fallback chain को प्राथमिकता देते हैं।
- T3 बड़े स्थानीय काम संभालता है। फ्लीट planning, coding, review और vision को 4B से 12B मॉडल पर भेजता है।
- T4 अधिक मात्रा वाले स्थानीय काम संभालता है। छोटे मॉडल routing, classification, extraction, embedding और सीमित code task करते हैं।
- हर GPU स्वतंत्र संसाधन है। एक कार्ड AI सेवा देता है, जबकि बाकी कार्ड माइनिंग करते रहते हैं।
- निष्क्रिय रहते समय स्थानीय मॉडल unload रहते हैं। अनुरोधों के बीच कोई मॉडल GPU memory नहीं रोकता।
- हर gateway एक ही logical catalog दिखाता है। साझा alias योग्य सिस्टम में काम बांटते हैं। जरूरत पड़ने पर node-prefixed alias सटीक placement रखते हैं।
- प्रयोगात्मक broker production में नहीं गया। उसके canary ने एक अनुरोध पूरा किया, फिर साफ shutdown test में विफल हुआ। LiteLLM सत्यापित request-scoped मार्ग पर रहा।
- Hermes और Aperture अभी तैयारी में हैं। लक्ष्य डिज़ाइन तैयार है, लेकिन end-to-end acceptance test बाकी है।
आवश्यकताएँ: कई Linux GPU host, स्थिर NVIDIA driver, Tailscale tailnet, systemd, काम करता miner, मॉडल संग्रहण और हर मॉडल मार्ग के acceptance test।
समय और कठिनाई: उन्नत। सूची तैयार करने, मॉडल डाउनलोड, service definition, routing test, failure drill और प्रति-कार्ड mining recovery जांच के लिए कई दिन रखें।
नीचे प्रयुक्त शब्द: tailnet Tailscale पहचान और उपकरणों से बना निजी नेटवर्क है। मॉडल alias क्लाइंट को दिखाया जाने वाला स्थिर मॉडल नाम है। मॉडल समूह एक alias के पीछे कई deployment रखता है। pool proxy छोटी स्थानीय service है जो GPU lease पर लेती है, मॉडल worker शुरू करती है और कार्ड को माइनिंग में लौटाती है।
डिज़ाइन का लक्ष्य
Agentic काम कई रूप लेता है। Repository सुधार के लिए title, screenshot, embedding या intent label से अलग मॉडल चाहिए। हर turn को सबसे बड़े मॉडल पर भेजना पैसा और स्थानीय क्षमता बर्बाद करता है। हर turn को सबसे छोटे मॉडल पर भेजने से retry बढ़ते हैं और नतीजे कमजोर होते हैं।
हम पाँच workload band वाला एक catalog चाहते थे। नीति को परिचित API format से hosted और स्थानीय मॉडल देने थे। AI अनुरोधों के बीच स्थानीय GPU को काम में रखना था।
फ्लीट को साथ-साथ कई काम भी करने थे। कई कार्ड वाला host एक समय में कई स्वतंत्र काम संभाले। एक कार्ड का अनुरोध chassis के सभी कार्डों की माइनिंग नहीं रोके।
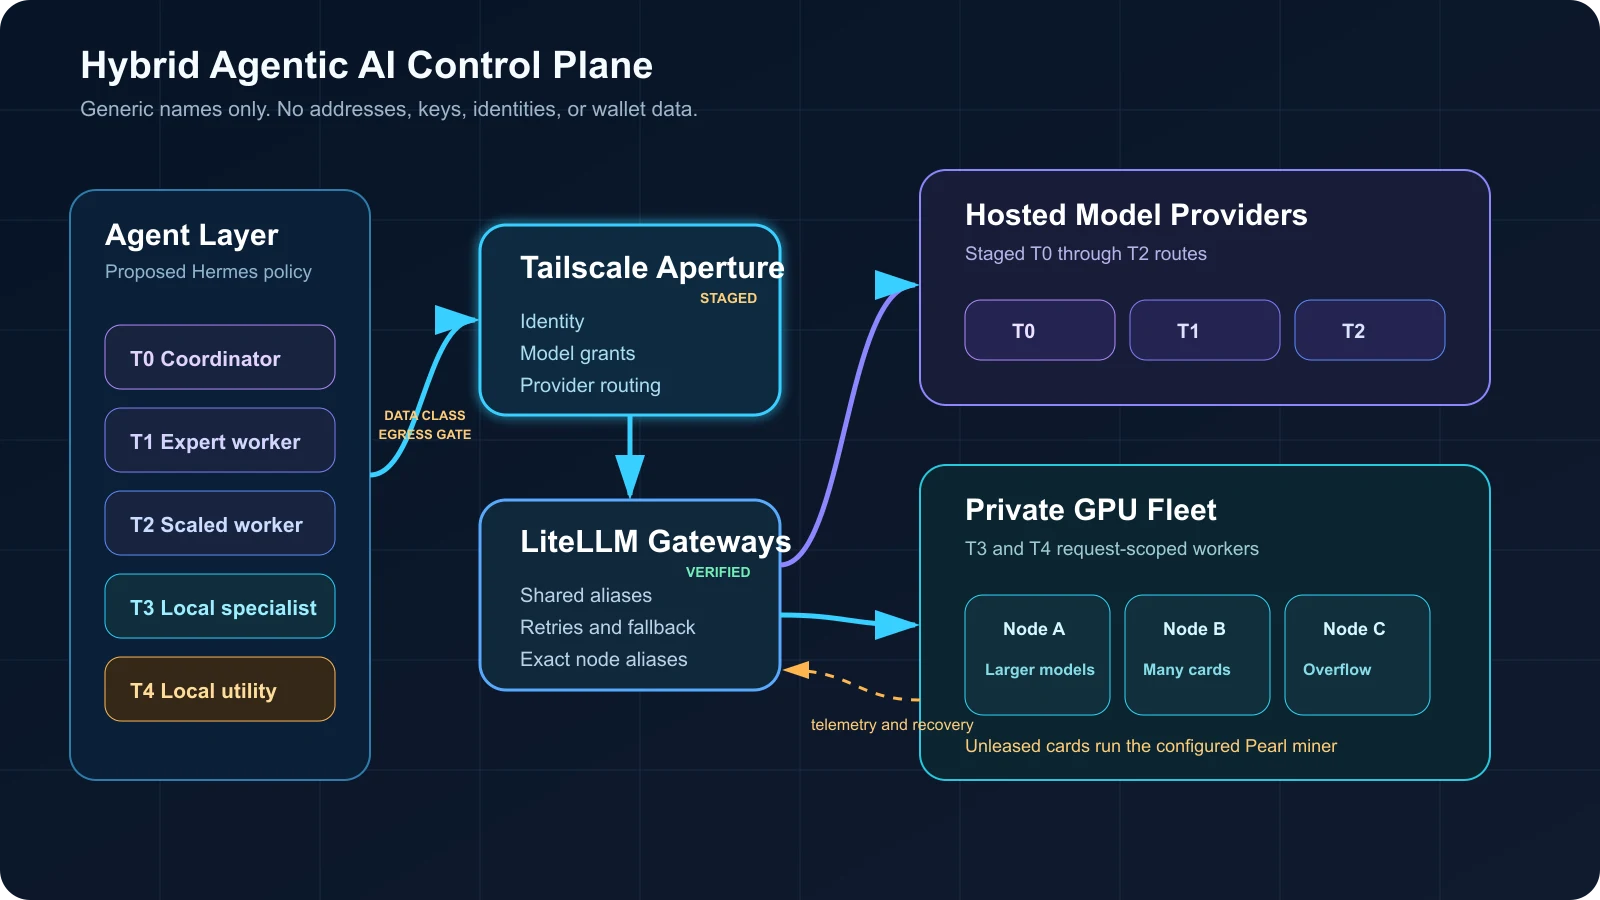
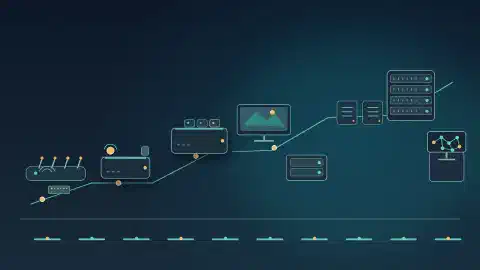
प्रस्तावित और तैयारी वाले नियंत्रण मार्ग सत्यापित LiteLLM तथा प्रति-GPU execution मार्ग के ऊपर हैं
चित्र में सामान्य node नाम हैं। इसमें निजी address, user पहचान, access key, wallet data या वास्तविक host label नहीं हैं।
T0 से T4 का अर्थ
Tier नाम हमारी routing policy बताते हैं। ये उद्योग मानक नहीं हैं और केवल मॉडल का आकार नहीं बताते।
| स्तर | मुख्य भूमिका | सामान्य गंतव्य | विफलता में व्यवहार |
|---|---|---|---|
| T0 | डिफ़ॉल्ट समन्वयक और सबसे कठिन निर्णय | होस्ट किया गया उन्नत तर्क मॉडल | क्रमबद्ध hosted fallback chain |
| T1 | उच्च-मूल्य worker agent | उच्च-क्षमता वाले होस्टेड मॉडल का समूह | तय chain के भीतर retry |
| T2 | सामान्य worker समूह | जरूरत पर उन्नयन सहित तेज होस्टेड मॉडल | कठिन काम को T1 या T0 तक बढ़ाना |
| T3 | पर्याप्त निजी स्थानीय काम | 4B से 12B स्थानीय चैट, कोड, समीक्षा और विज़न मॉडल | योग्य स्थानीय नोड पर फिर प्रयास, फिर प्रतिबंधित डेटा के लिए सुरक्षित अस्वीकृति |
| T4 | सीमित और बार-बार होने वाला स्थानीय काम | 0.6B से 3B स्थानीय रूटिंग, वर्गीकरण, कोड और एम्बेडिंग मॉडल | स्थानीय प्रतिलिपि पर फिर प्रयास या उसी डेटा सीमा में T3 पर जाना |
Tier पहले काम बताते हैं, फिर मॉडल। सुरक्षा-संवेदनशील छोटा classification T4 में आता है। लंबी repository योजना T3 या ऊपर जाती है। कठिन architecture निर्णय छोटा prompt होने पर भी ऊंचे स्तर से शुरू होता है।
यह बंटवारा agent economics भी बदलता है। T4 worker बार-बार होने वाले कम-जोखिम बदलाव संभालते हैं। T3 worker सामान्य code और analysis को tailnet के भीतर रखते हैं। कठिन काम और recovery के लिए T0 से T2 उपलब्ध रहते हैं।
हर hosted fallback से पहले data-class gate होना चाहिए। Public, internal और restricted कामों की chain अलग होती है। Restricted काम स्थानीय रहता है और विफल होने पर fail closed करता है। Boundary पार करने वाले retry के लिए साफ़ किया input और user या workflow की स्पष्ट अनुमति चाहिए। Hosted call से पहले redaction credential, repository secret, निजी tool output और संवेदनशील retrieval content हटाता है।
Hermes कार्य नीति कैसे संभालेगा
Hermes प्रस्तावित agent layer है। लक्ष्य नीति model class तय करती है, tools चलाती है, काम सौंपती है और स्पष्ट fallback chain का पालन करती है। Hermes मुख्य मॉडल, auxiliary job, delegated agent और task-specific fallback के लिए अलग route दस्तावेज़ करता है। यह base URL के माध्यम से custom OpenAI-compatible endpoint भी स्वीकारता है। Hermes कॉन्फ़िगरेशन मार्गदर्शिका और वैकल्पिक provider मार्गदर्शिका देखें।
हमारी नीति Hermes job को भौतिक server के बजाय स्थिर alias से जोड़ती है। उदाहरण:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
Alias काम का उद्देश्य बताता है। Hermes को यह जानने की जरूरत नहीं कि कौन-सा GPU खाली है, किस node में बड़ा कार्ड है या कौन-सा replica health check में विफल हुआ। निचली परतें ये निर्णय करती हैं।
कुछ कामों में अभी भी तय placement जरूरी है। Node-prefixed model ID operator diagnostic या benchmark को चुने हुए सिस्टम तक भेजता है। अलग Aperture grant इन alias को operator तक सीमित रखें। सामान्य agent traffic साझा tier alias उपयोग करता है।
Model access से agent tool सुरक्षित नहीं होते। Hermes rollout में least-privilege tool allowlist, अलग workspace, सीमित credential, network egress control और prompt injection handling चाहिए। Delegated worker को उसके काम से अधिक access नहीं मिलना चाहिए।
Aperture तैयारी में पहचान की सीमा है
Tailscale हर service को public internet पर रखे बिना configured gateway और inference host जोड़ता है। Aperture को user-facing boundary और model router के रूप में तैयार किया जा रहा है। इस route का end-to-end acceptance test बाकी है। Tailscale tailnet पर encrypted client access और TLS द्वारा provider forwarding को Aperture कैसे काम करता है में बताता है।
Aperture पहुंच और अनुमति को अलग रखता है। इसके grant डिफ़ॉल्ट रूप से deny करते हैं। Gateway तक पहुंचने के बाद user या tagged device के लिए मेल खाता model grant जरूरी है। Aperture grant मार्गदर्शिका additive grant model और identity source समझाता है।
तैनाती से पहले तैयारी वाले Aperture configuration को चार नियम मानने चाहिए:
- एक नामित identity के पास admin role है। सामान्य model access से administration नहीं मिलता।
- Provider स्पष्ट model ID सूचीबद्ध करते हैं। Aperture upstream service से मॉडल का अनुमान नहीं लगाता।
- Provider URL tailnet address पर जाते हैं। निजी node नाम और address लेख तथा सार्वजनिक configuration उदाहरण से बाहर रहें।
- Secret service-owned file में रहें। तैनाती से पहले केवल मालिक की अनुमति, सीमित service account, rotation और log redaction लागू करें। Diagnostic output में LiteLLM key, tailnet address, subscription token या wallet data कभी न दिखाएं।
Aperture आने वाले request path को हर provider base URL के साथ जोड़ता है। इसका
कॉन्फ़िगरेशन संदर्भ
provider root में दोहराया /v1 suffix न रखने की चेतावनी देता है। Integration risk के कारण इसके लिए स्पष्ट validation check रखा गया।
Vision image content के साथ OpenAI Chat Completions format पर जाने को तैयार है। Embedding सीधे निजी LiteLLM endpoint उपयोग करते हैं, क्योंकि वर्तमान Aperture self-hosted provider matrix chat format बताती है, जबकि हमारा embedding path chat picker से बाहर LiteLLM और llama.cpp endpoint पर निर्भर है। समर्थित प्रदाता और क्लाइंट संदर्भ देखें।
सीधे embedding मार्ग को अपनी authorization boundary चाहिए। LiteLLM authentication, कड़े Tailscale grant, tailnet interface पर service binding और host firewall rule से पहुंच केवल स्वीकृत identity या service tag तक सीमित होनी चाहिए। केवल निजी address authorization policy नहीं है।
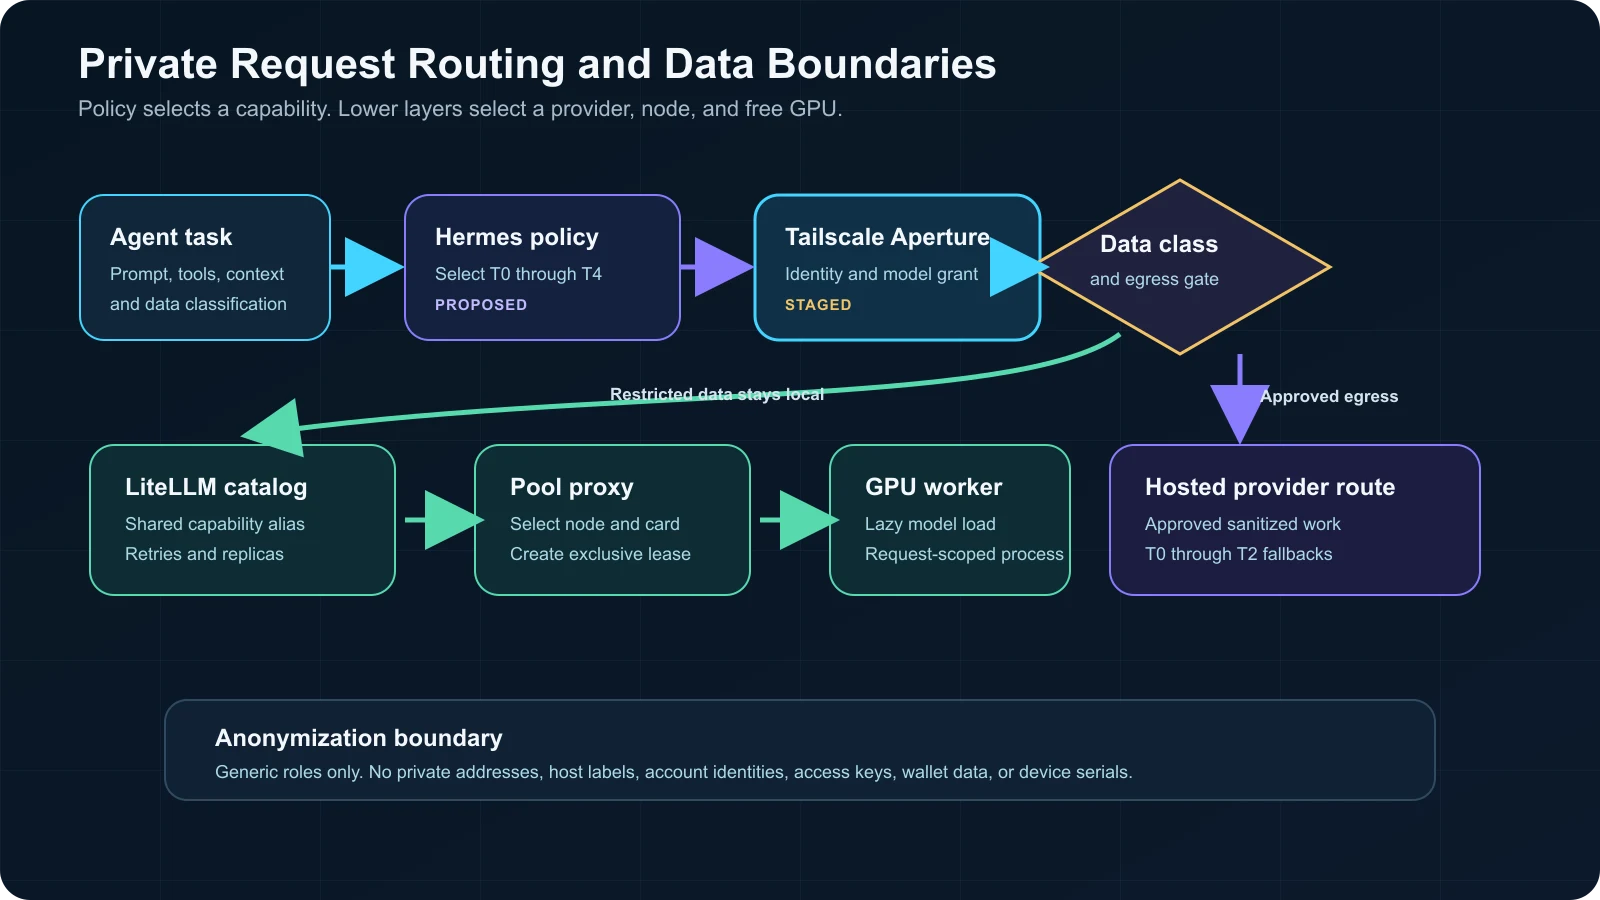
Identity, grant और data classification तय करते हैं कि अनुरोध निजी फ्लीट से बाहर जाएगा या नहीं
LiteLLM एक सूची प्रस्तुत करता है
हर inference host LiteLLM gateway चलाता है। मॉडल दूसरे node पर हो तब भी हर gateway एक ही logical model catalog दिखाता है। क्लाइंट एक API shape और alias का एक set रखता है।
LiteLLM कई deployment को एक model name के पीछे समूहित करता है। इसका router फिर योग्य deployment चुनता है और retry, timeout, cooldown या fallback लागू करता है। मौजूदा LiteLLM रूटिंग दस्तावेज़ साझा model name, routing strategy और retry behavior बताता है।
Catalog में दो address style हैं:
| Address style | उदाहरण | उपयोग |
|---|---|---|
| Shared alias | t4-classify | योग्य node के बीच सामान्य काम बांटना |
| Node alias | node-b/qwen-small | Diagnostic चलाना या placement बनाए रखना |
Shared alias Hermes बदले बिना horizontal scale देते हैं। योग्य replica जोड़ने से model group बढ़ता है। खराब replica हटाने से group घटता है।
हम GPU lifecycle logic को LiteLLM के नीचे रखते हैं। Gateway की memory footprint GPU memory नहीं रोकती, इसलिए gateway चालू रहता है। स्थानीय pool proxy चुने गए model request को पाता है, एक कार्ड lease पर लेता है, worker शुरू करता है और response के बाद उसे बंद कर देता है।
स्थानीय मॉडल सूची
फ्लीट 12B parameter या उससे छोटे मॉडल चुनता है। यह सीमा उपलब्ध card memory से मेल खाती है और context तथा runtime buffer के लिए जगह छोड़ती है।
Model notation: B का अर्थ अरबों parameter है। K का अर्थ configured context token के हजार है। Quantization कम numeric precision में model weight रखकर memory उपयोग घटाता है। KV cache सक्रिय context की attention state रखता है और prompt के साथ बढ़ता है। E4B छोटे Gemma 4 variant के लिए Google का आकार नाम है।
| स्तर मार्ग | मॉडल वर्ग | निर्धारित संदर्भ | मुख्य काम | स्थान |
|---|---|---|---|---|
| T3 बुद्धिमान | Qwen3.5 9B, quantized | 64K | कठिन स्थानीय योजना और सामान्य agent कार्य | अधिक memory वाले GPU node |
| T3 कोड | Granite 4.2 8B, quantized | 64K | Repository काम, tool, terminal task, structured output | अधिक memory वाले GPU node |
| T3 समीक्षा | Gemma 4 12B, quantized | 32K | स्वतंत्र समीक्षा और वैकल्पिक reasoning | अधिक memory वाले GPU node |
| T3 सामान्य और विज़न | Qwen3.5 4B, quantized | 32K | बड़े पैमाने पर सामान्य काम और image समझ | हर संगत GPU |
| T3 वैकल्पिक समीक्षा | Gemma 4 E4B, quantized | 8K | विविध review मार्ग | हर संगत GPU |
| T4 कोड | Granite 4.2 3B, quantized | 16K | छोटे edit, tool call, structured output | हर संगत GPU |
| T4 वर्गीकरण | Qwen3.5 2B, quantized | 16K | Classification, extraction और rewriting | हर संगत GPU |
| T4 राउटर | Qwen3.5 0.8B, high precision quantization | 16K | Intent, label, title और छोटे बदलाव | हर संगत GPU |
| T4 एम्बेडिंग | Qwen3 Embedding 0.6B, quantized | 32K | Agent memory, RAG, code retrieval और clustering | हर संगत GPU |
ये context value deployment setting हैं, advertised model limit नहीं। बड़ी advertised window भी KV cache और runtime memory लेती है। एक कार्ड पर स्थिर सेवा के लिए हमने कम value चुने।
Qwen Qwen3.5 को multimodal family बताता है और Qwen3.5 संग्रह में छोटे से बड़े dense variant देता है। IBM Granite 4.2 8B के agentic coding और लंबे context के नतीजे प्रकाशित करता है। Google कहता है Gemma 4 multimodal input, function calling और बड़ी advertised window देता है।
Embedding route chat model से vector मांगने के बजाय अलग model उपयोग करता है। Qwen3 Embedding 0.6B मॉडल कार्ड में 32K sequence length, multilingual retrieval, code retrieval और 1,024 तक output dimension सूचीबद्ध हैं।
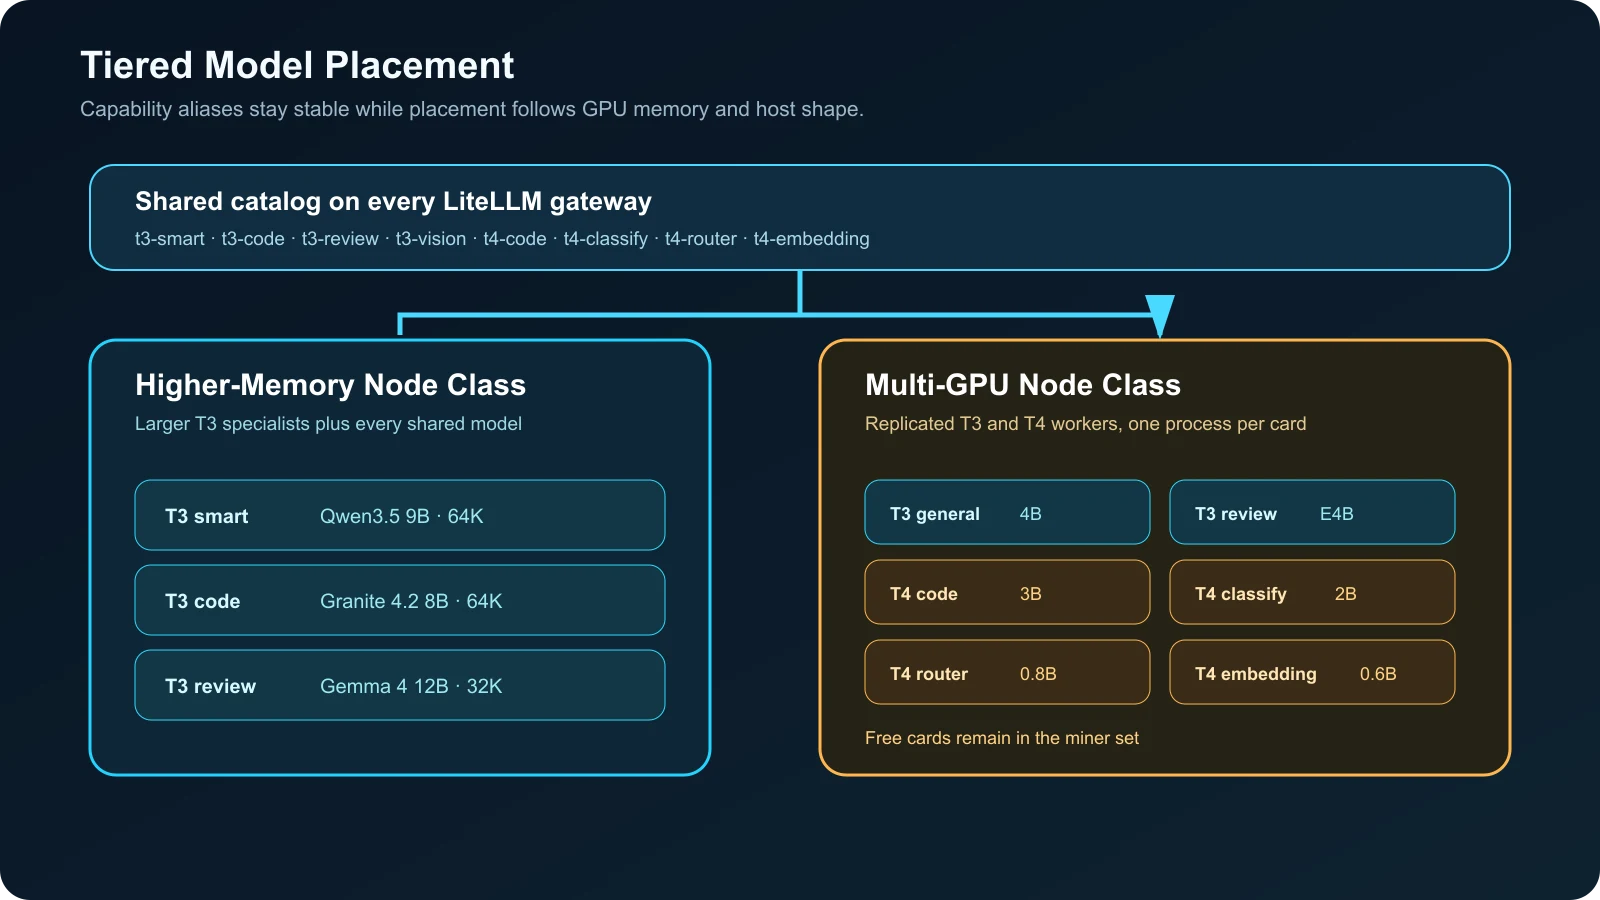
बड़े विशेषज्ञ अधिक memory वाले कार्ड पर रहते हैं और छोटे विशेषज्ञ पूरे फ्लीट में दोहराए जाते हैं
llama.cpp उत्पादन में क्यों चलता है
llama.cpp संसाधन मॉडल से मेल खाता है। एक static worker एक GPU, एक model file, एक configured context और एक lease से जुड़ा है। Process boundary startup, teardown, GPU visibility और log का audit आसान बनाती है।
इसका server OpenAI-compatible chat, responses और embeddings देता है। यह parallel decoding और continuous batching भी समर्थन करता है। मौजूदा server documentation multimodal support को experimental कहता है। ये सुविधाएं llama.cpp सर्वर दस्तावेज़ में हैं।
बड़े node पर Ollama compatibility path के रूप में उपलब्ध है। Memory पर्याप्त होने पर Ollama concurrent model load और
Ollama के अक्सर पूछे जाने वाले प्रश्न
में बताए keep_alive: 0 से तत्काल unload समर्थन करता है। प्रति-कार्ड production path के लिए Ollama नहीं चुना क्योंकि static llama.cpp worker से placement और teardown पर अधिक सटीक नियंत्रण मिला।
हमने Strata भी देखा। Strata बड़े Qwen mixture-of-experts मॉडल को GPU memory, system RAM और storage में फैलाता है। उसके प्रकाशित preset 32 GB संयुक्त memory से शुरू होते हैं, जबकि low-RAM mode कम क्षमता के बदले गति घटाता है। Strata कोड रिपॉज़िटरी देखें। Strata का उद्देश्य अलग है: एक या अधिक कार्डों पर एक बड़ा hybrid model। हमारा फ्लीट कई स्वतंत्र 12B से छोटे worker पसंद करता है।
प्रति GPU मांग पर लोडिंग
हर model worker पर मांग पर लोडिंग लागू होती है। अनुरोधों के बीच सिस्टम केवल gateway, pool proxy, watchdog और miner चालू रखता है।
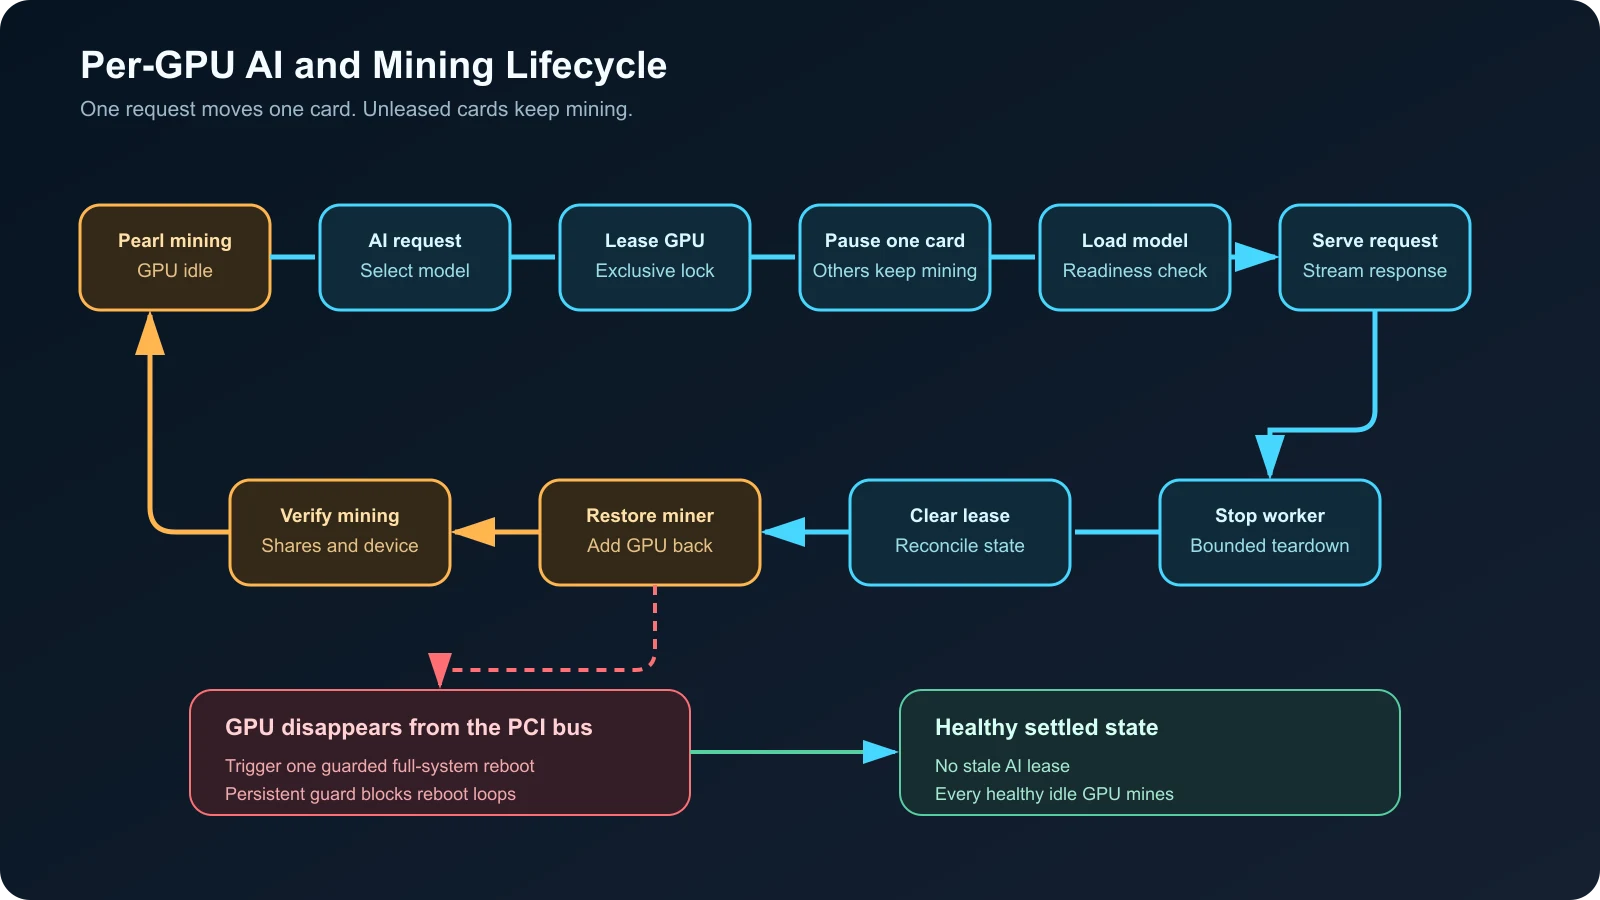
केवल lease पर लिया कार्ड miner से हटता है, model process समाप्त होने पर लौट आता है
Request lifecycle के चरण:
- LiteLLM deployment चुनता है। अनुरोध चुनी model class के pool proxy तक पहुंचता है।
- Pool lease लेता है। Lock दो exclusive worker को एक कार्ड लेने से रोकता है।
- एक GPU हटाकर miner restart होता है। हर unleased कार्ड Pearl command में रहता है।
- Lease वाले device पर llama.cpp शुरू होता है। Proxy request भेजने से पहले readiness check पूरे होते हैं।
- Worker response देता है। समानांतर request अन्य खाली कार्डों पर worker शुरू करते हैं।
- Worker exit करता है। Process teardown के बाद pool lease हटाता है।
- छोड़े GPU के साथ miner restart होता है। Health check पुष्टि करता है कि कार्ड फिर mining में है।
यह पूरे host को एक साथ बदलने से अलग है। कई कार्ड वाला chassis कई model सेवा देता है और बाकी कार्ड mining करते हैं। Idle होने पर फ्लीट हर स्वस्थ GPU को Pearl में लौटाता है।
Pearl श्वेतपत्र इसके matrix-computation proof system का वर्णन करता है। हमारा architecture profitability forecast या आर्थिक return के दावे पर निर्भर नहीं है। Mining निष्क्रिय समय के लिए configured workload है।
शुरुआत से ज्यादा विफलता प्रबंधन महत्वपूर्ण है
Model startup lifecycle का केवल आधा हिस्सा है। जबरन stop, GPU गायब होना, बीच में रुके request, stale lease और miner restart को स्पष्ट रूप से संभालना पड़ता है।
हमारा watchdog configured GPU set की live NVIDIA device list से तुलना करता है। GPU के सचमुच गायब होने की पुष्टि पर एक guarded full-system reboot होता है। सुरक्षित production trigger में बार-बार विफल जांच, cooldown, active job drain, persistent reboot counter और remote alert होने चाहिए। एक recovery विफल होते ही automation रुके और manual intervention मांगे।
वही watchdog stale lease भी मिलाता है। कोई worker lease नहीं रखता तो reconciliation stale record हटाकर GPU को miner में लौटाता है। Broker canary के दौरान यह recovery path काम आया।
| विफलता | प्रतिक्रिया |
|---|---|
| Model readiness विफल | Worker रोकें, lease छोड़ें, mining लौटाएं और error दें |
| Request अप्रत्याशित रूप से समाप्त | Cleanup समय सीमित करें, worker process tree समाप्त करें और lease reconcile करें |
| GPU गायब | बार-बार अनुपस्थिति की पुष्टि करें, active काम रोकें, एक guarded reboot करें, alert दें, फिर पूरे configured GPU set की जांच करें |
| Miner निष्क्रिय कार्ड छोड़ता है | Active lease से device list फिर बनाकर miner restart करें |
| LiteLLM deployment विफल | उसी model group के दूसरे replica पर retry करें, फिर fallback policy अपनाएं |
| Aperture grant route रोकता है | Identity या model grant सुधारें, gateway policy को bypass न करें |
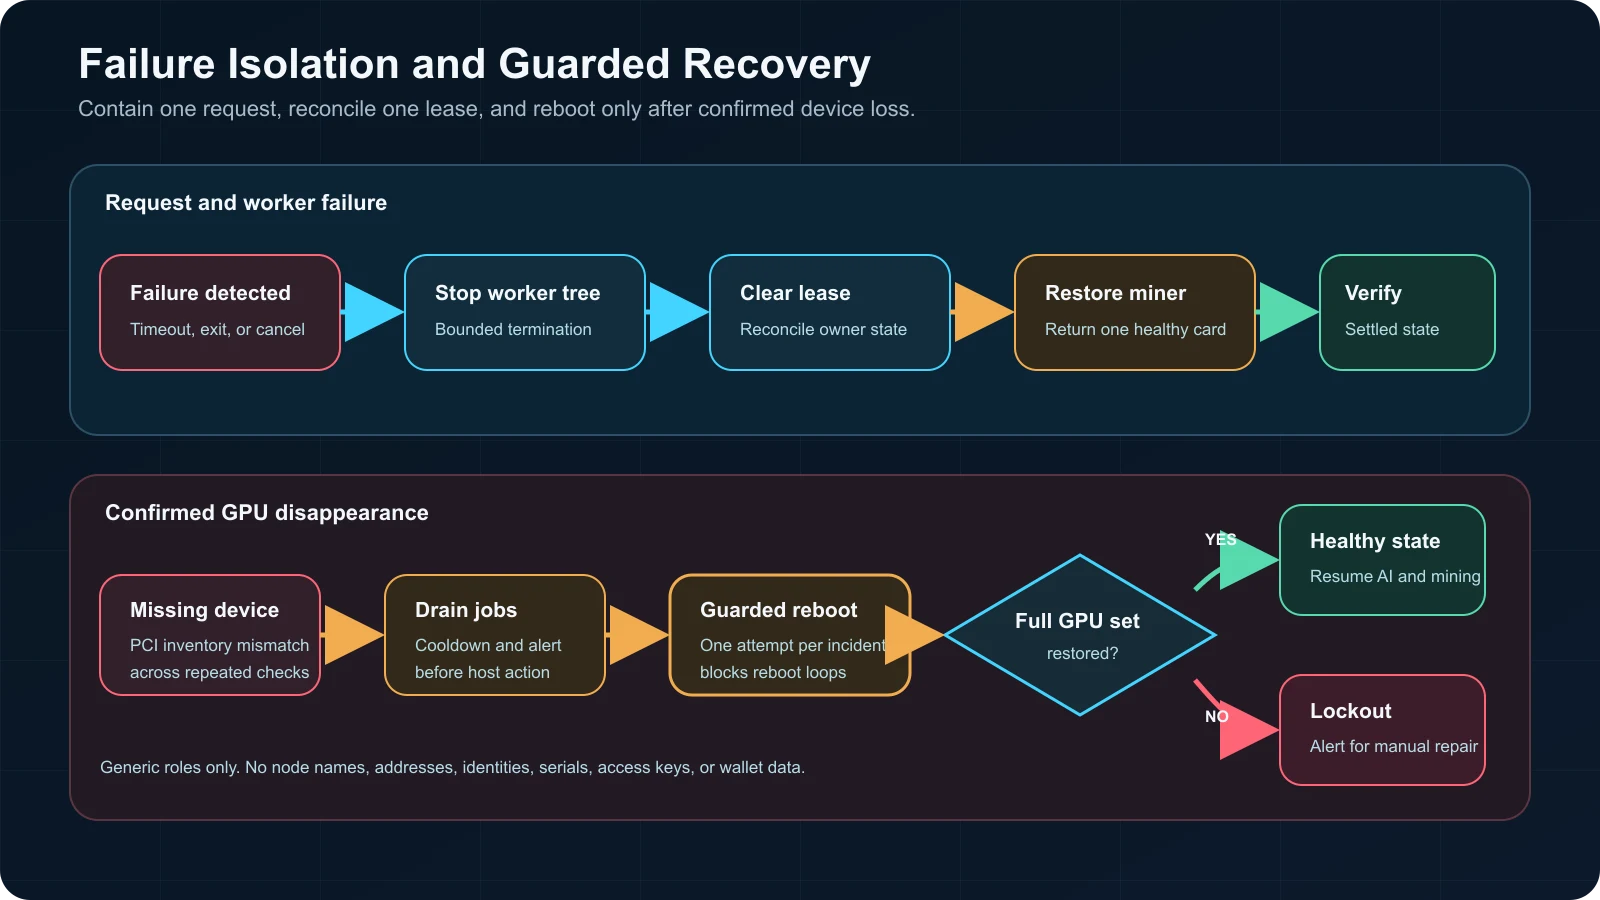
सामान्य failure एक lease छोड़ता है, जबकि पुष्टि की गई device loss guarded host-recovery path चलाती है
प्रयोगात्मक मध्यस्थ के साथ क्या हुआ
बैकएंड-निरपेक्ष मध्यस्थ Ollama, vLLM, llama.cpp और Strata पर एक OpenAI-compatible interface देने का लक्ष्य रखता है। इसमें हर मॉडल के लिए lifecycle management, idle unload और GPU placement शामिल हैं।
हमने 21 अक्टूबर 2026 को commit c12b65 पर broker version 0.6.0 जांचा। इसके local suite में 1,101 test pass और 2 skip हुए, Ruff साफ था। Canary ने मांग पर मॉडल load किया और सफल chat request दिया। अनुरोध के समय दूसरे GPU mining करते रहे।
Shutdown से lifecycle की गंभीर समस्या पता चली। Model load होने के बाद systemd द्वारा process tree मारने तक broker अपने stop path में अटका रहा। जबरन stop ने stale GPU lease छोड़ा, जिसे reconciliation ने बाद में ठीक करके miner लौटाया। Documented required-GPU setting और production adapter के enforcement में भी अंतर मिला।
हमने production path में broker बंद कर दिया। LiteLLM अब request-scoped pool proxy से route करता है। Child process का bounded shutdown, process-group termination, required-GPU admission check और stale-lease cleanup integration test पास करने तक broker प्रयोगात्मक रहेगा।
यह उपयोगी engineering सीख है। एक बार मॉडल start करना broker को प्रमाणित नहीं करता। Production readiness के लिए साफ teardown, bounded recovery, exclusive device admission और दोहराए जा सकने वाले failure drill जरूरी हैं।
किए गए सत्यापन
Deployment test ने model response से अधिक जांचा:
- हर साझा chat model ने कम-से-कम एक योग्य host पर load, answer, exit और Pearl recovery cycle पूरा किया।
- Vision ने chat route से image input स्वीकारा।
- Embedding ने निजी LiteLLM path से configured vector size दिया।
- अलग कार्डों पर कई model एक समय में चले।
- एक साथ AI request के दौरान unleased कार्ड miner में रहे।
- साझा alias ने योग्य node के बीच routing की।
- Node-prefixed alias ने तय placement बनाए रखा।
- हर LiteLLM gateway में एक ही logical catalog था।
- एक full host reboot के बाद गायब GPU वापस आया। Watchdog में अब persistent loop guard है।
- Lease reconciliation ने broker shutdown failure संभाला।
- अंतिम स्थिर स्थिति में कोई AI lease नहीं था और हर स्वस्थ GPU फिर miner set में था।
Health check और model listing को model-load test नहीं माना। अच्छा acceptance test वास्तविक request भेजता है, response जांचता है, चुना GPU पक्का करता है, teardown देखता है और mining recovery सत्यापित करता है।
फ्लीट की समस्याएँ सुलझाना
| लक्षण | पहली जांच |
|---|---|
| Model दिखता है लेकिन request विफल है | Upstream model ID, API format, auth header और provider base URL |
| Aperture 405 लौटाता है | Provider root में duplicate /v1 suffix न हो |
| गलत node request को सेवा देता है | Shared alias या node-prefixed alias |
| दो worker एक कार्ड चाहते हैं | Lease lock, stale lease state और GPU admission logic |
| हर कार्ड पर mining रुकता है | Miner restart code active lease से device list बनाता है या नहीं |
| GPU mining से बाहर रहती है | Worker process tree, lease reconciliation और miner device list |
| Cold load धीमा है | Model size, storage speed, PCIe link width और host CPU pressure |
| लंबे prompt विफल होते हैं | Configured context, KV cache headroom और output reservation |
| Aperture में embedding route नहीं है | Tailscale identity और host firewall policy से सीमित authenticated LiteLLM route लें |
| Broker stop अटकता है | Broker route बंद कर traffic सत्यापित pool proxy पर लौटाएं |
रखने योग्य डिज़ाइन नियम
- काम के उद्देश्य से route करें। केवल model size tier तय नहीं करता।
- Placement के ऊपर policy रखें। Hermes capability alias चुनता है। LiteLLM deployment चुनता है। Pool GPU चुनता है।
- हर GPU अलग lease है। पूरे host को बदलना उपलब्ध कार्ड बर्बाद करता है।
- हर idle model unload करें। चालू gateway को चालू GPU worker की जरूरत नहीं।
- सीमित exact-placement path रखें। केवल operator के node alias से diagnostic दोहराए जा सकते हैं।
- पहले teardown जांचें। Miner recovery और lease cleanup acceptance test का हिस्सा हैं।
- Chat, vision और embedding अलग रखें। एक gateway का अर्थ एक protocol path नहीं।
- Diagram से निजी विवरण हटाएं। Address, key, पहचान या wallet data नहीं, role और flow दिखाएं।
- Reboot logic पर guard लगाएं। बार-बार अनुपस्थिति, cooldown, persistent counter, alert और एक recovery विफल होने पर manual intervention जरूरी करें।
- प्रयोगात्मक bypass रखें। Broker की विफलता सत्यापित route को साथ न गिराए।
अगले कदम
अगला चरण workload evaluation है। हर tier के लिए तय task set, acceptance criteria, latency record, GPU occupancy, mining interruption time और escalation rate चाहिए। माप बताएंगे कि कौन-सा T2 काम T3 में और कौन-सा T3 काम T4 में जा सकता है।
हम Hermes से Aperture होते LiteLLM तक पहला acceptance test चलाने, फिर shutdown और GPU admission सुधार के बाद broker का दोबारा परीक्षण करने की योजना बनाते हैं। उसी routing catalog में जुड़ने से पहले image generation के लिए अपना lazy OpenAI-compatible adapter चाहिए।
Model size के लिए स्थानीय AI मॉडल और GPU context guide पढ़ें। Privacy boundary के लिए स्थानीय AI privacy और सुरक्षा पढ़ें। Miner setup और जोखिम के लिए Pearl माइनिंग मार्गदर्शिका देखें। निष्क्रिय mining को निश्चित लाभ न मानें।
Related Posts