AI साइबर सुरक्षा प्रमाणपत्र: अभ्यास के साथ तालमेल नहीं

Table of Contents
हमने परीक्षाएँ दीं। हम पास हुए। हमें प्रमाणपत्र मिले, लेकिन साथ में एक निराशा भी मिली जिसे मैं स्पष्ट रूप से बताना चाहता हूँ।
यह इन कार्यक्रमों को बनाने वाले लोगों की शिकायत नहीं है। वे अधूरी सामग्री के साथ काम कर रहे हैं। AI सुरक्षा एक नया क्षेत्र है। हमलों पर शोध, रक्षात्मक उपकरणों से तेज़ी से आगे बढ़ रहा है। शासन ढाँचे इंजीनियरिंग मार्गदर्शन से पहले आए।
समस्या प्रमाणपत्रों में सिखाई जाने वाली बात और उत्पादन में AI प्रणालियों को सुरक्षित रखने के लिए आवश्यक ज्ञान के बीच का अंतर है।
तीन परतें जिन्हें अक्सर गड़बड़ किया जाता है
क्या कमी है, यह समझाने से पहले मौजूदा चीज़ों को अलग-अलग देखना उपयोगी है।
पहली परत शासन है। NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 और EU AI Act जैसे दस्तावेज़ संगठन और प्रक्रिया के स्तर पर काम करते हैं। वे बताते हैं कि AI जोखिम कैसे सँभालें, निगरानी कैसे बनाएँ और जवाबदेही कैसे दर्ज करें। वे जानबूझकर विशिष्ट नियंत्रण बताने के बजाय शासन पर केंद्रित हैं। यही उनकी रूपरेखा है।
दूसरी परत खतरा वर्गीकरण है। MITRE ATLAS, ATT&CK के समान प्रारूप में AI प्रणालियों के विरुद्ध विरोधी रणनीतियों का दस्तावेज़ बनाता है। OWASP Top 10 for Large Language Model Applications, तैनात LLM के लिए सबसे प्रासंगिक हमले की श्रेणियाँ सूचीबद्ध करता है। ये दस्तावेज़ हमलों के नाम बताते हैं और उनका तरीका समझाते हैं। वे बचाव के उपाय निर्धारित नहीं करते।
तीसरी परत तकनीकी मार्गदर्शन है। इसमें Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) और Anthropic, OpenAI तथा Meta जैसे विक्रेताओं के विशिष्ट सुरक्षा दस्तावेज़ शामिल हैं। ये सुरक्षित तैनाती, मूल्यांकन पद्धतियों और रनटाइम नियंत्रणों के लिए इंजीनियरिंग स्तर का मार्गदर्शन देते हैं।
अधिकांश AI शासन प्रमाणपत्र पहली परत को विस्तार से पढ़ाते हैं। दूसरी परत का सारांश देते हैं। तीसरी परत को शायद ही छूते हैं।
प्रमाणपत्र क्या सिखाते हैं
वर्तमान में उपलब्ध AI शासन और सुरक्षा प्रमाणपत्र, जिनमें IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, ISO 42001 प्रमाणपत्र और CompTIA AI+ शामिल हैं, मिलते-जुलते विषय पढ़ाते हैं।
आप NIST AI RMF और इसके चार कार्य Govern, Map, Measure और Manage को अपने संगठन की AI तैनाती से जोड़ना सीखते हैं। आप EU AI Act के जोखिम स्तर और उच्च जोखिम वाली प्रणालियों के अनुरूपता मूल्यांकन की प्रक्रिया सीखते हैं। आप पूर्वाग्रह, निष्पक्षता, पारदर्शिता और जवाबदेही को शासन के सिद्धांतों के रूप में सीखते हैं। आप AI शासन नीतियाँ लिखना और प्रभाव मूल्यांकन करना भी सीखते हैं।
ये वास्तविक कौशल हैं। संगठनों को ऐसे लोग चाहिए जो शासन ढाँचे समझते हों, NIST AI RMF पढ़ते हों और जानते हों कि यह उनसे क्या बनाने को कहता है।
प्रमाणपत्र समान गहराई से ये बातें नहीं सिखाते:
- हमलावर आज उत्पादन में AI प्रणालियों से कैसे समझौता करते हैं
- प्रॉम्प्ट इंजेक्शन के विरुद्ध defense-in-depth परिचालन में कैसा दिखता है और एक नियंत्रण इसे पूरी तरह क्यों नहीं रोकता
- तैनाती से पहले मॉडल की अखंडता कैसे जाँचें
- AI-विशिष्ट रेड टीमिंग में क्या शामिल है और उसका दायरा कैसे तय करें
- लॉन्च से पहले विरोधी इनपुट के विरुद्ध मॉडल व्यवहार का मूल्यांकन कैसे करें
- इन्फरेंस के समय AI observability कैसी दिखती है
- AI incident response, मानक IR playbook से कैसे अलग है
- टूल एक्सेस और बाहरी एकीकरण वाले AI एजेंटों को सुरक्षित करने के लिए क्या चाहिए
NIST AI RMF शासन है, इंजीनियरिंग नहीं
NIST AI RMF एक अच्छी तरह बनाया गया दस्तावेज़ है। NIST ने इसे तकनीक-निरपेक्ष, क्षेत्र-निरपेक्ष और अलग-अलग AI विकास तरीकों पर लागू होने योग्य बनाया। इससे यह ढाँचा व्यापक रूप से लागू होता है।
इसका अर्थ यह भी है कि यह विशिष्ट हमले की श्रेणियों के लिए तकनीकी नियंत्रण निर्धारित नहीं करता। यदि आपका संगठन AI RMF को पूरी तरह अपनाकर उसके सभी कार्य अपनी AI तैनाती से जोड़ता है, तो आपके पास जोखिम प्रक्रियाओं का दस्तावेज़ होगा। इससे तैनात भाषा मॉडल पर प्रॉम्प्ट इंजेक्शन के विरुद्ध बचाव सुनिश्चित नहीं होता।
NIST इसे स्वीकार करता है। 2024 में प्रकाशित NIST AI 600-1, Generative AI Profile, जनरेटिव AI और बड़े भाषा मॉडल के लिए AI RMF का विस्तार करता है। इसमें प्रॉम्प्ट इंजेक्शन, डेटा पॉइज़निंग और सूचना संबंधी खतरों जैसे जोखिम मूल AI RMF से अधिक विशिष्टता के साथ शामिल हैं। यदि आपके प्रमाणन में AI 600-1 के बिना केवल मूल AI RMF था, तो आपने वर्तमान में तैनात प्रणालियों के लिए सबसे प्रासंगिक दस्तावेज़ छोड़ दिया।
ISO 42001 और प्रबंधन प्रणाली की तुलना
ISO 42001:2023 AI प्रबंधन प्रणाली का मानक है। यह संगठन स्तर पर AI विकास और तैनाती के शासन के लिए संरचना देता है। सुरक्षा पेशेवरों को इसमें सूचना सुरक्षा के ISO 27001 से समानता दिखेगी।
ISO 27001 व्यापक रूप से अपनाया गया है। प्रमाणित संगठन भी उल्लंघन का शिकार होते हैं। प्रमाणन दर्ज करता है कि प्रबंधन प्रणाली मौजूद है, परिभाषित प्रक्रिया का पालन करती है और उसकी समीक्षा होती है। यह प्रमाणित नहीं करता कि उस प्रक्रिया के अधीन प्रणालियाँ उन पर होने वाले हमलों का सामना करेंगी।
ISO 42001 संगठनात्मक अनुशासन देता है। प्रमाणन हितधारकों को बताता है कि AI प्रक्रियाएँ दर्ज हैं, उनकी समीक्षा होती है और वे शासन के अधीन हैं। यह साबित नहीं करता कि तैनात मॉडल विरोधी परिस्थितियों में लगातार सही परिणाम देंगे, एजेंट तय विश्वास सीमाओं में काम करेंगे या fine-tuned मॉडल सत्यापित प्रशिक्षण डेटा से बने हैं।
ISO 27001 में भी यही अंतर है। पारंपरिक साइबर सुरक्षा में हमने इसके साथ काम करना सीखा। हमें यह दिखावा नहीं करना चाहिए कि AI शासन प्रमाणपत्र इस अंतर को मिटाते हैं, जबकि उनमें वही संरचनात्मक सीमा है।
EU AI Act परिणाम माँगता है, इंजीनियरिंग विनिर्देश नहीं
EU AI Act AI प्रणालियों को जोखिम स्तर के आधार पर बाँटता है: अस्वीकार्य (प्रतिबंधित), उच्च (अनुरूपता मूल्यांकन आवश्यक), सीमित (पारदर्शिता दायित्व) और न्यूनतम (कोई विशिष्ट आवश्यकता नहीं)।
महत्वपूर्ण अवसंरचना, बायोमेट्रिक पहचान, नियुक्ति छँटाई, शिक्षा और कानून प्रवर्तन में इस्तेमाल होने वाली उच्च जोखिम की प्रणालियों पर तकनीकी दस्तावेज़, मानव निगरानी और मजबूती की आवश्यकताएँ लागू होती हैं। कानून स्पष्ट रूप से माँगता है कि उच्च जोखिम वाली AI प्रणालियाँ विरोधी हेरफेर के ज़रिए व्यवहार बदलने के प्रयासों का सामना करें।
यह आवश्यकता कानून के पाठ में है। कानून जानबूझकर तकनीकी नियंत्रणों के बजाय परिणाम निर्धारित करता है। सभी तैनाती परिस्थितियों, प्रणाली प्रकारों और उपयोगों में विरोधी मजबूती साबित करने के तकनीकी तरीके पर अभी सहमति नहीं है।
EU AI Act पर आधारित प्रमाणपत्र आपको AI प्रणालियों का वर्गीकरण, तकनीकी दस्तावेज़ लिखना और निगरानी प्रोटोकॉल बनाना सिखाते हैं। वे ऑडिट की तैयारी कराते हैं। कानून की मजबूती आवश्यकताएँ पूरी करने वाली प्रणाली बनाने का इंजीनियरिंग कार्य वर्तमान प्रमाणपत्रों से अलग क्षेत्र में आता है।
AI प्रणालियों पर वास्तव में कौन से हमले होते हैं
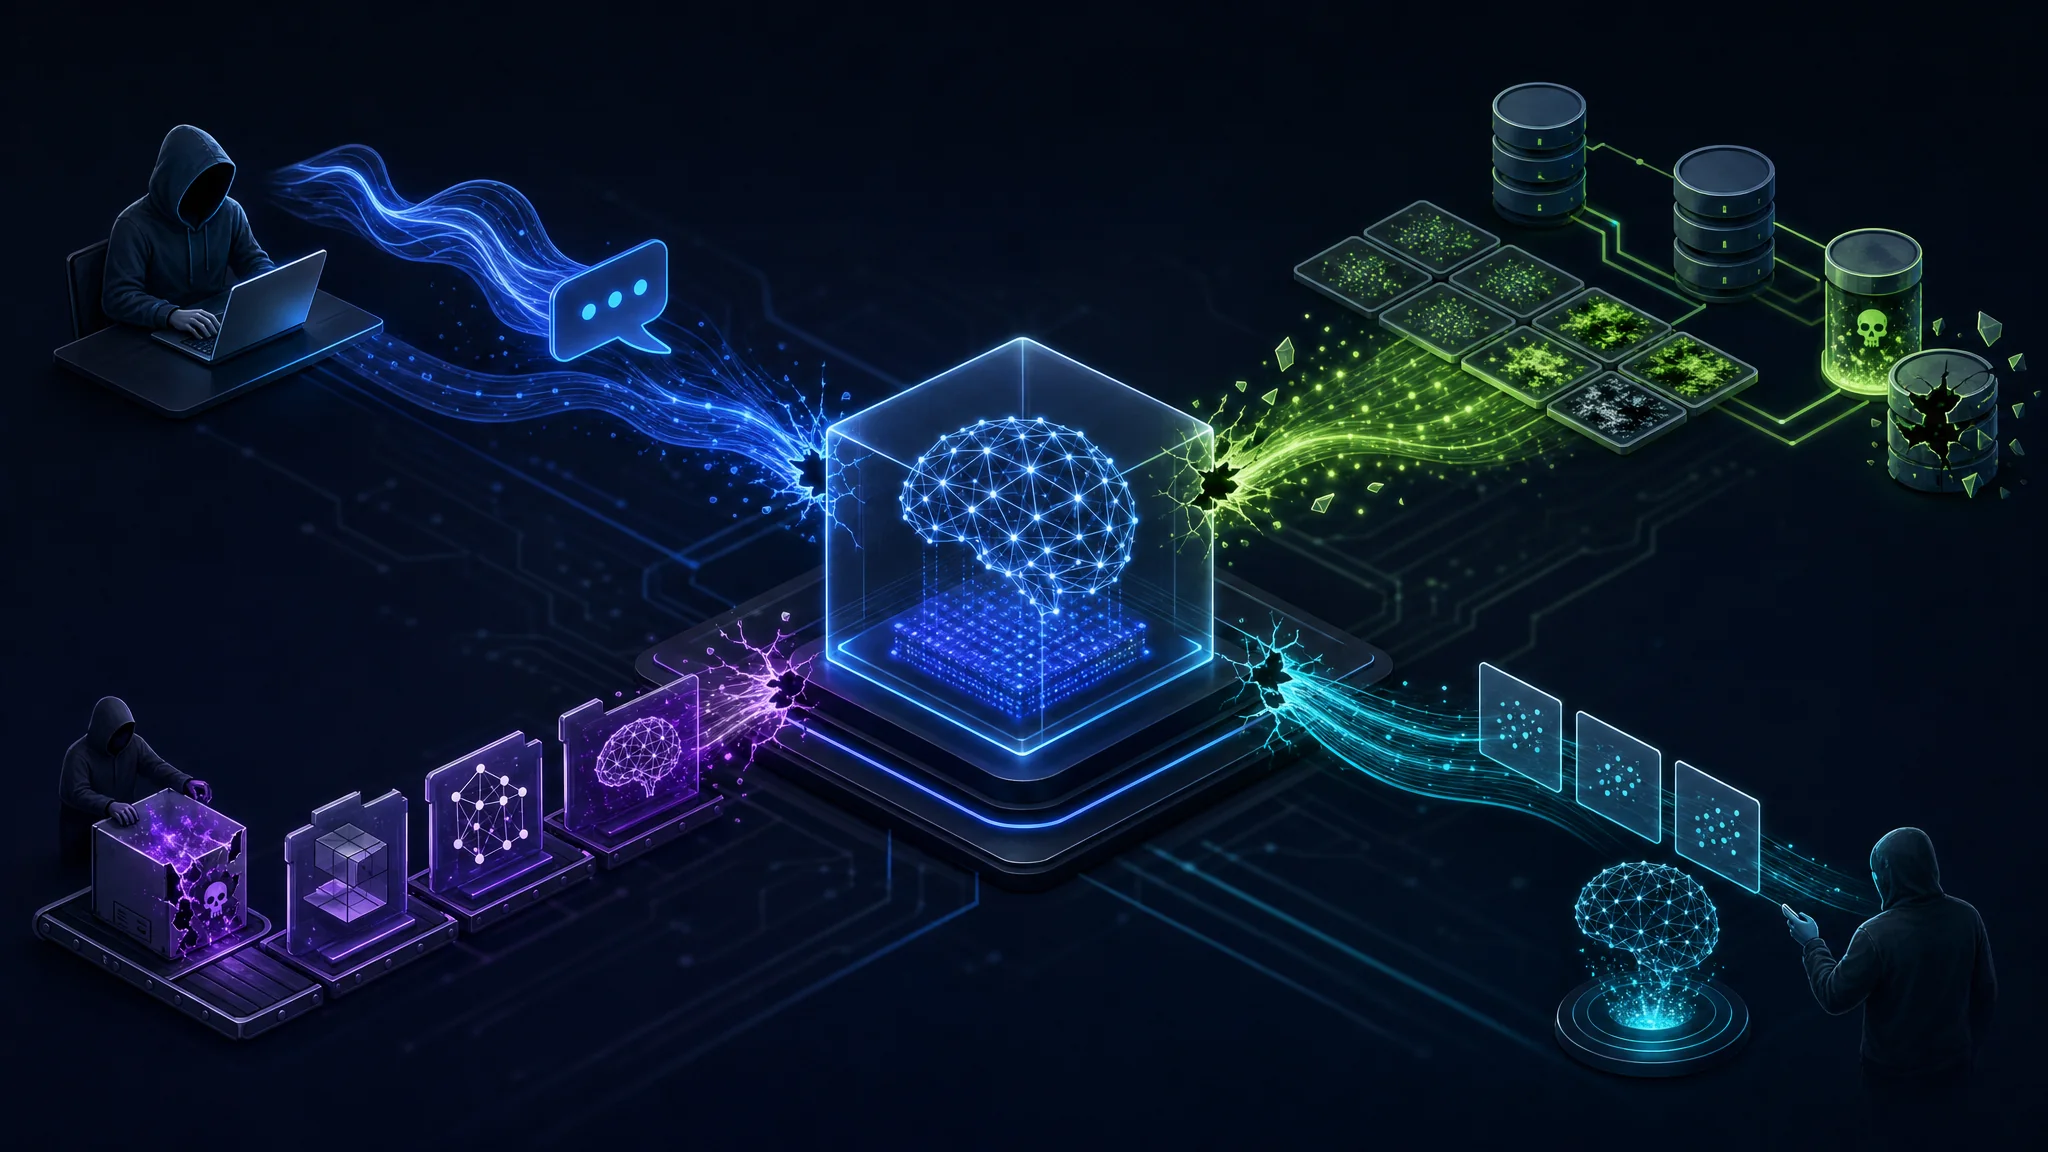
MITRE ATLAS और OWASP LLM Top 10 परिचालन खतरा परिदृश्य दर्ज करते हैं। ये उपयोगी स्तर के विवरण में हमलों की सूची देते हैं। शासन ढाँचे खतरों का अधिक अमूर्त उल्लेख करते हैं। आगे की जानकारी सुरक्षा-विशिष्ट स्रोतों से है।
प्रॉम्प्ट इंजेक्शन भाषा मॉडल को ऐसा इनपुट देकर काम करता है जो system instruction को बदलता या प्रभावित करता है। सीधा इंजेक्शन मॉडल के इनपुट को निशाना बनाता है। अप्रत्यक्ष इंजेक्शन उस सामग्री में दुर्भावनापूर्ण निर्देश छिपाता है जिसे मॉडल पुनः प्राप्त, संसाधित या संक्षेप करता है। आपकी RAG pipeline हमलावर के नियंत्रण वाला दस्तावेज़ पढ़ती है और उसमें छिपे निर्देशों पर काम करती है। आपका browsing agent हमलावर के नियंत्रण वाला पृष्ठ खोलकर उसमें दिए निर्देश मानता है। आपका customer support bot ऐसे सहायता लेख का सार देता है जिसमें सुरक्षा दिशानिर्देश अनदेखा करने को कहा गया है।
2026 तक प्रॉम्प्ट इंजेक्शन के लिए सार्वभौमिक रूप से प्रभावी बचाव नहीं है। Defense-in-depth इनपुट फ़िल्टरिंग, आउटपुट सत्यापन, सीमित अधिकार वाले टूल, अलग-थलग execution वातावरण और महत्वपूर्ण कार्रवाइयों पर मानव अनुमोदन से जोखिम घटाता है। इनमें से कोई भी उपाय पूरी हमले की श्रेणी को समाप्त नहीं करता। NIST, OWASP, Anthropic, OpenAI, Google और Microsoft एकल समाधान के बजाय स्तरित नियंत्रण सुझाते हैं।
प्रशिक्षण डेटा पॉइज़निंग, मॉडल व्यवहार बिगाड़ने, backdoor जोड़ने या trigger-आधारित व्यवहार डालने के लिए प्रशिक्षण डेटा में दुर्भावनापूर्ण उदाहरण जोड़ता है। मॉडल के विशिष्ट trigger इनपुट देखने तक सफल पॉइज़निंग का संकेत अक्सर नहीं मिलता। यदि आपका संगठन स्रोत सत्यापित किए बिना user-generated content, पुनः प्राप्त दस्तावेज़ या तृतीय पक्ष dataset से मॉडल fine-tune करता है, तो यह जोखिम है।
मॉडल आपूर्ति श्रृंखला से समझौता ऐसा खतरा है जिसे अधिकतर संगठन बाद की चिंता मानते हैं। मॉडल repository अक्सर model weights के साथ executable code भी वितरित करते हैं। pickle जैसे असुरक्षित serialization format ने बार-बार supply chain जोखिम पैदा किए हैं। मॉडल डाउनलोड के साथ आने वाले package अपनी कमजोरियों वाली dependencies इंस्टॉल कर सकते हैं। सार्वजनिक repository से मॉडल लेते समय कई संगठन software dependency की तुलना में बहुत कम supply-chain जाँच करते दिखते हैं। attack surface npm जैसा है, लेकिन इसके आसपास सुरक्षा संस्कृति अभी शुरुआती है।
मॉडल निकालने से हमलावर आपके API को बार-बार inference query भेजकर कार्यात्मक रूप से समान मॉडल पुनर्निर्मित कर सकते हैं। इससे बौद्धिक संपदा का नुकसान होता है और अधिक लक्षित हमले बनाने के लिए मॉडल का offline अध्ययन संभव होता है।
सदस्यता अनुमान से हमलावर अलग-अलग विश्वास स्तर पर पता लगा सकते हैं कि विशिष्ट डेटा रिकॉर्ड प्रशिक्षण सेट में था या नहीं। यह मॉडल architecture और प्रशिक्षण पद्धति पर निर्भर है। निजी जानकारी से मॉडल प्रशिक्षित करने वाले संगठनों के लिए गोपनीयता जोखिम बनता है।
विरोधी इनपुट सोच-समझकर बनाए गए बदलावों से मॉडल आउटपुट को प्रभावित करते हैं। इस तकनीक का सबसे अधिक अध्ययन image classification में हुआ है, लेकिन यह text, audio और multimodal प्रणाली पर भी लागू होती है। यदि आपका AI धोखाधड़ी पहचान, साख, मेडिकल इमेजिंग या भौतिक पहुँच पर निर्णय लेता है, तो विरोधी मजबूती ऐसी सुरक्षा विशेषता है जिसे जाँचना चाहिए, केवल दस्तावेज़ नहीं करना।
AI प्रणालियों से डेटा लीक पर सीधा ध्यान देना चाहिए। RAG pipeline आपके ज्ञान-आधार के दस्तावेज़ ऐसे उपयोगकर्ताओं को दिखा सकती है जिन्हें पहुँच नहीं होनी चाहिए। system instruction से prompt leak परिचालन विवरण खोलता है जिन्हें गोपनीय रखना था। Multi-tenant AI तैनाती में अलगाव आवश्यक है, जिसे पारंपरिक application security इंजीनियर कभी-कभी कम आँकते हैं। तैनात प्रणालियों में ये परिचालन जोखिम नियमित रूप से दिखते हैं।
AI एजेंट आक्रमण सतह पूरी तरह बदल देते हैं
अधिकांश AI सुरक्षा प्रमाणपत्र उस समय लिखे गए जब AI प्रणाली से मुख्यतः chatbot और classifier समझे जाते थे। 2026 में enterprise AI का अर्थ तेजी से agent हो रहा है।
एक परिचालन रूप से महत्वपूर्ण बात में एजेंट chatbot से अलग हैं: वे कार्रवाई करते हैं। ईमेल सिस्टम, आंतरिक database, file system, browser और code execution तक tool access वाला agent अधिक सुविधाओं वाला chatbot नहीं है। यह भाषा मॉडल के आउटपुट के आधार पर वास्तविक प्रणालियों तक महत्वपूर्ण पहुँच रखने वाली स्वायत्त प्रक्रिया है।
OWASP अब अलग Agentic AI Top 10 रखता है, क्योंकि एजेंट का threat model LLM chat application से इतना अलग है कि अलग दस्तावेज़ की आवश्यकता है।
एजेंट के संदर्भ में प्रॉम्प्ट इंजेक्शन अनचाहा पाठ उत्तर नहीं, अनचाही कार्रवाई पैदा करता है। पुनः प्राप्त दस्तावेज़ में अप्रत्यक्ष निर्देश एजेंट को फाइलें मिटाने, डेटा बाहर भेजने या ईमेल भेजने को कह सकता है। परिणाम अनुचित उत्तर नहीं, बल्कि एजेंट की पहुँच वाले सिस्टम पर अनधिकृत कार्रवाई है।
एजेंट की आक्रमण सतह में शामिल हैं:
- Tool invocation सीमा: क्या एजेंट हर काम के लिए उपयुक्त न्यूनतम टूल तक सीमित है
- Credential scope: क्या एजेंट के credential हर काम की आवश्यकता तक सीमित हैं
- Action reversibility: क्या महत्वपूर्ण कार्रवाई से पहले मानव अनुमोदन चाहिए
- Output filtering: क्या आगे की कार्रवाई शुरू होने से पहले agent output की जाँच होती है
- Sandboxing: क्या execution वातावरण जुड़े सिस्टम तक अनचाही पहुँच रोकता है
अधिकांश AI शासन प्रमाणपत्र इस स्तर की विशिष्टता के साथ agent सुरक्षा डिज़ाइन नहीं पढ़ाते।
Model Context Protocol नया enterprise attack surface बनाता है
Model Context Protocol (MCP), AI एजेंटों को बाहरी टूल, डेटा स्रोत और सेवा से जोड़ने का व्यापक मानक बन गया है। MCP server ऐसी क्षमताएँ खोलते हैं जिन्हें एजेंट खोजकर इस्तेमाल करते हैं। एकीकरण तेज़ और लचीला है, लेकिन सुरक्षा प्रभावों पर हमेशा उतना ही ध्यान नहीं दिया जाता।
MCP के विशिष्ट जोखिम हैं:
- दुर्भावनापूर्ण MCP server जो एजेंट को अपनी क्षमता गलत बताकर अनचाही कार्रवाई करते हैं
- Tool poisoning, जिसमें वैध MCP server हमलावर के नियंत्रण वाला डेटा लौटाता है और डेटा output के भीतर निर्देश जोड़ता है
- अधिक अधिकार वाले tool, जहाँ MCP integration काम की आवश्यकता से ज्यादा permission रखता है
- Trust boundary भ्रम, जहाँ एजेंट जुड़े MCP tool के निर्देशों को उपयोगकर्ता के निर्देशों के समान मानते हैं
MCP integration वाले agent तैनात करने वाली संस्था को MCP server के भरोसे का मूल्यांकन, tool permission audit और tool response को निर्देश नहीं बल्कि डेटा मानने की पुष्टि के लिए framework चाहिए।
मूल्यांकन वह परिचालन अभ्यास है जिसे प्रमाणपत्र छोड़ देते हैं
तैनाती से पहले और बाद में AI model जोखिम समझने के मुख्य तरीकों के रूप में AI red teaming और evaluation suite स्थिर सुरक्षा आकलनों की जगह ले रहे हैं।
AI red teaming में शामिल है:
- ज्ञात हमले की तकनीकों के विरुद्ध model behavior की संरचित विरोधी जाँच
- स्थापित prompt attack dataset के विरुद्ध jailbreak benchmark
- बदले हुए input पर output में बदलाव मापने वाले adversarial robustness test
- model version के बीच behavioral regression test
- प्रकाशित evaluation suite के विरुद्ध safety benchmark मूल्यांकन
NIST, Anthropic, OpenAI, Microsoft, Google और CISA उच्च-जोखिम प्रणाली तैनात करने से पहले AI-विशिष्ट red teaming की सलाह देते हैं। यह वैकल्पिक अभ्यास नहीं, मानक अपेक्षा बन रहा है।
मौजूदा AI शासन प्रमाणपत्रों में से कोई भी तैनात मॉडल या agent system के विरुद्ध red teaming का दायरा तय करने, इसे चलाने या नतीजे समझने के लिए पर्याप्त तैयारी नहीं देता। वे बताते हैं कि red teaming क्या है, लेकिन करना नहीं सिखाते।
AI observability अलग क्षेत्र है
पारंपरिक सुरक्षा logging को सीधे AI प्रणाली पर लागू नहीं किया जा सकता। उत्पादन में LLM या agent की निगरानी के लिए अलग डेटा संग्रह और विश्लेषण चाहिए।
AI observability अवसंरचना में शामिल हैं:
- anomaly और policy violation पहचानने के लिए prompt तथा output telemetry
- agent के tool invocation log, जिनमें चले tool और arguments हों
- RAG pipeline में retrieval quality monitoring
- jailbreak प्रयास का पता लगाना और वर्गीकरण
- model version के बीच बदलाव पकड़ने के लिए output consistency monitoring
- तथ्यात्मक शुद्धता महत्त्वपूर्ण हो ऐसे application के लिए hallucination rate tracking
- ऐसे latency pattern जो context आकार बढ़ाने वाले prompt injection प्रयास का संकेत दें
यह उभरता हुआ क्षेत्र है। 2026 में AI तैनात करने वाले अधिकतर संगठनों को पारंपरिक अवसंरचना की तुलना में AI component की observability काफी कम है। अधिकांश शासन प्रमाणपत्र यह नहीं बताते कि AI प्रणाली के लिए पर्याप्त observability कैसी होती है।
AI incident response सामान्य IR जैसा नहीं
पारंपरिक प्रणाली compromise होने पर IR playbook containment, forensics और recovery संभालता है। AI incident ऐसे सवाल लाते हैं जिनका उत्तर standard playbook में नहीं है।
ज़रूरत पड़ने से पहले इन सवालों के playbook तैयार करें:
- कैसे निर्धारित करेंगे कि fine-tuning के दौरान model poison हुआ था
- कैसे जाँचेंगे कि हमलावर के नियंत्रण वाली सामग्री लौटाने के लिए RAG retrieval का दुरुपयोग हुआ
- कैसे पहचानेंगे कि agent ने अनधिकृत कार्रवाई की और उसका दायरा क्या था
- कैसे सत्यापित करेंगे कि तीसरे पक्ष के provider के model update ने सुरक्षा की दृष्टि से व्यवहार बदला
- incident के बाद तुलना के लिए incident से पहले model का व्यवहार कैसे स्थापित करेंगे
इनके लिए घटना से पहले तैयारी, पहले से स्थापित log और telemetry, तथा AI-विशिष्ट runbook चाहिए जो केवल network traffic और endpoint log नहीं, model behavior की forensics के लिए भी जगह रखें।
प्रमाणपत्र अपडेट करने की समस्या
प्रमाणपत्र मौजूदा अभ्यास से पीछे रहने का एक संरचनात्मक कारण है: AI सुरक्षा, प्रमाणपत्र अपडेट चक्र की गति से तेज़ बदलती है।
Security+, CISSP और ISO 27001 ऐसे क्षेत्र कवर करते हैं जो वर्षों में बदलते हैं। network, endpoint और application की मुख्य attack surface अपेक्षाकृत स्थिर हैं। AI attack technique महीनों में बदलती हैं। 2026 की prompt injection technique, विरोधी attack method और agentic attack surface, 2023 तथा 2024 में पहले AI प्रमाणपत्र लॉन्च होने के समय से अलग हैं।
प्रमाणन निकाय निर्धारित कार्यक्रम पर सामग्री अपडेट करते हैं। OWASP LLM Top 10 ने अपने पहले साल में महत्वपूर्ण संशोधन प्रकाशित किया। कई मौजूदा AI प्रमाणपत्र बनते समय MCP enterprise चिंता नहीं था। Agentic AI सुरक्षा framework अधिकांश मौजूदा पाठ्यक्रम के बाद आए।
यह संरचनात्मक समस्या है, इरादे की विफलता नहीं। प्रमाणपत्र को स्थिर ज्ञान मानने के बजाय प्राथमिक स्रोत लगातार पढ़ें।
AI सुरक्षा प्रमाणपत्र की सामग्री में क्या होना चाहिए
वर्तमान AI सुरक्षा अभ्यास दिखाने के लिए प्रमाणन पाठ्यक्रम में ये विषय होने चाहिए:
- Prompt injection defense-in-depth: input filtering, output validation, tool scoping, sandboxing और human approval gate, साथ ही प्रत्येक की दर्ज सीमाएँ
- Model supply chain verification: असुरक्षित serialization जोखिम, SBOM आवश्यकता, provenance documentation और signed artifact सत्यापन
- AI agent security architecture: trust boundary, न्यूनतम privilege वाला tool access, action reversibility और monitoring आवश्यकता
- MCP और external integration सुरक्षा: tool server trust मूल्यांकन, tool permission audit और data तथा instruction अलग रखना
- Evaluation और red teaming: adversarial evaluation का scope कैसे तय करें, कौन से benchmark और evaluation dataset हैं, और नतीजे कैसे समझें
- AI observability: AI प्रणाली को कौन से log और telemetry चाहिए तथा incident पहचान और प्रतिक्रिया में उनका उपयोग
- AI-विशिष्ट incident response: AI incident scenario की पूर्वयोजना, model behavior संबंधी प्रमाण एकत्र करना और AI प्रणालियों की विशेष recovery आवश्यकताएँ
- Data leakage रोकथाम: RAG isolation, prompt confidentiality, multi-tenant access control और output filtering
अभी आपको क्या करना चाहिए
यदि आप अपने संगठन की AI प्रणाली के लिए जिम्मेदार हैं:
OWASP Top 10 for Large Language Model Applications और OWASP Agentic AI Top 10 पढ़ें। ये निःशुल्क हैं और मौजूदा paid certification पाठ्यक्रम से अधिक परिचालन-विशिष्ट हैं।
AI component पर अगली threat modeling बैठक से पहले MITRE ATLAS देखें। deployment design अंतिम करने से पहले जानें कि आपके architecture पर कौन-सी adversary tactic लागू होती है।
NIST AI 600-1 पढ़ें। यह मूल AI RMF को generative AI के लिए विशेष रूप से बढ़ाता है और केवल मूल framework की तुलना में LLM तथा agent deployment के लिए काफी अधिक प्रासंगिक है।
Google SAIF, Microsoft’s AI SDL और OWASP AI Exchange देखें। ये वह engineering guidance देते हैं जो governance framework नहीं देते।
आपका संगठन हर तैनात model की provenance सत्यापित करे। model card जाँचें। weight load करने से पहले serialization format को ज्ञात exploit class के लिए scan करें।
अपने environment के हर AI agent का access map करें। आंतरिक knowledge base, email और file system पर पढ़ने-लिखने की पहुँच वाला agent prompt injection का प्रभाव बढ़ाता है। उसके credential हर काम की जरूरत तक सीमित करें।
किसी भी model या agent को गंभीर परिणाम वाले संदर्भ में तैनात करने से पहले AI-विशिष्ट red teaming अनिवार्य करें। इसे विकल्प नहीं, शर्त मानें।
ज़रूरत पड़ने से पहले अभी AI-विशिष्ट incident response runbook बनाएँ।
अपने शासन प्रमाणपत्र को process layer के दस्तावेज़ के रूप में देखें। यह आपकी सुरक्षा स्थिति का दस्तावेज़ नहीं है।
संदर्भ
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation
Related Posts