2x RTX 5060 Ti बनाम GB10: 32 GB VRAM, 128 GB यूनिफाइड मेमोरी से क्यों हारती है
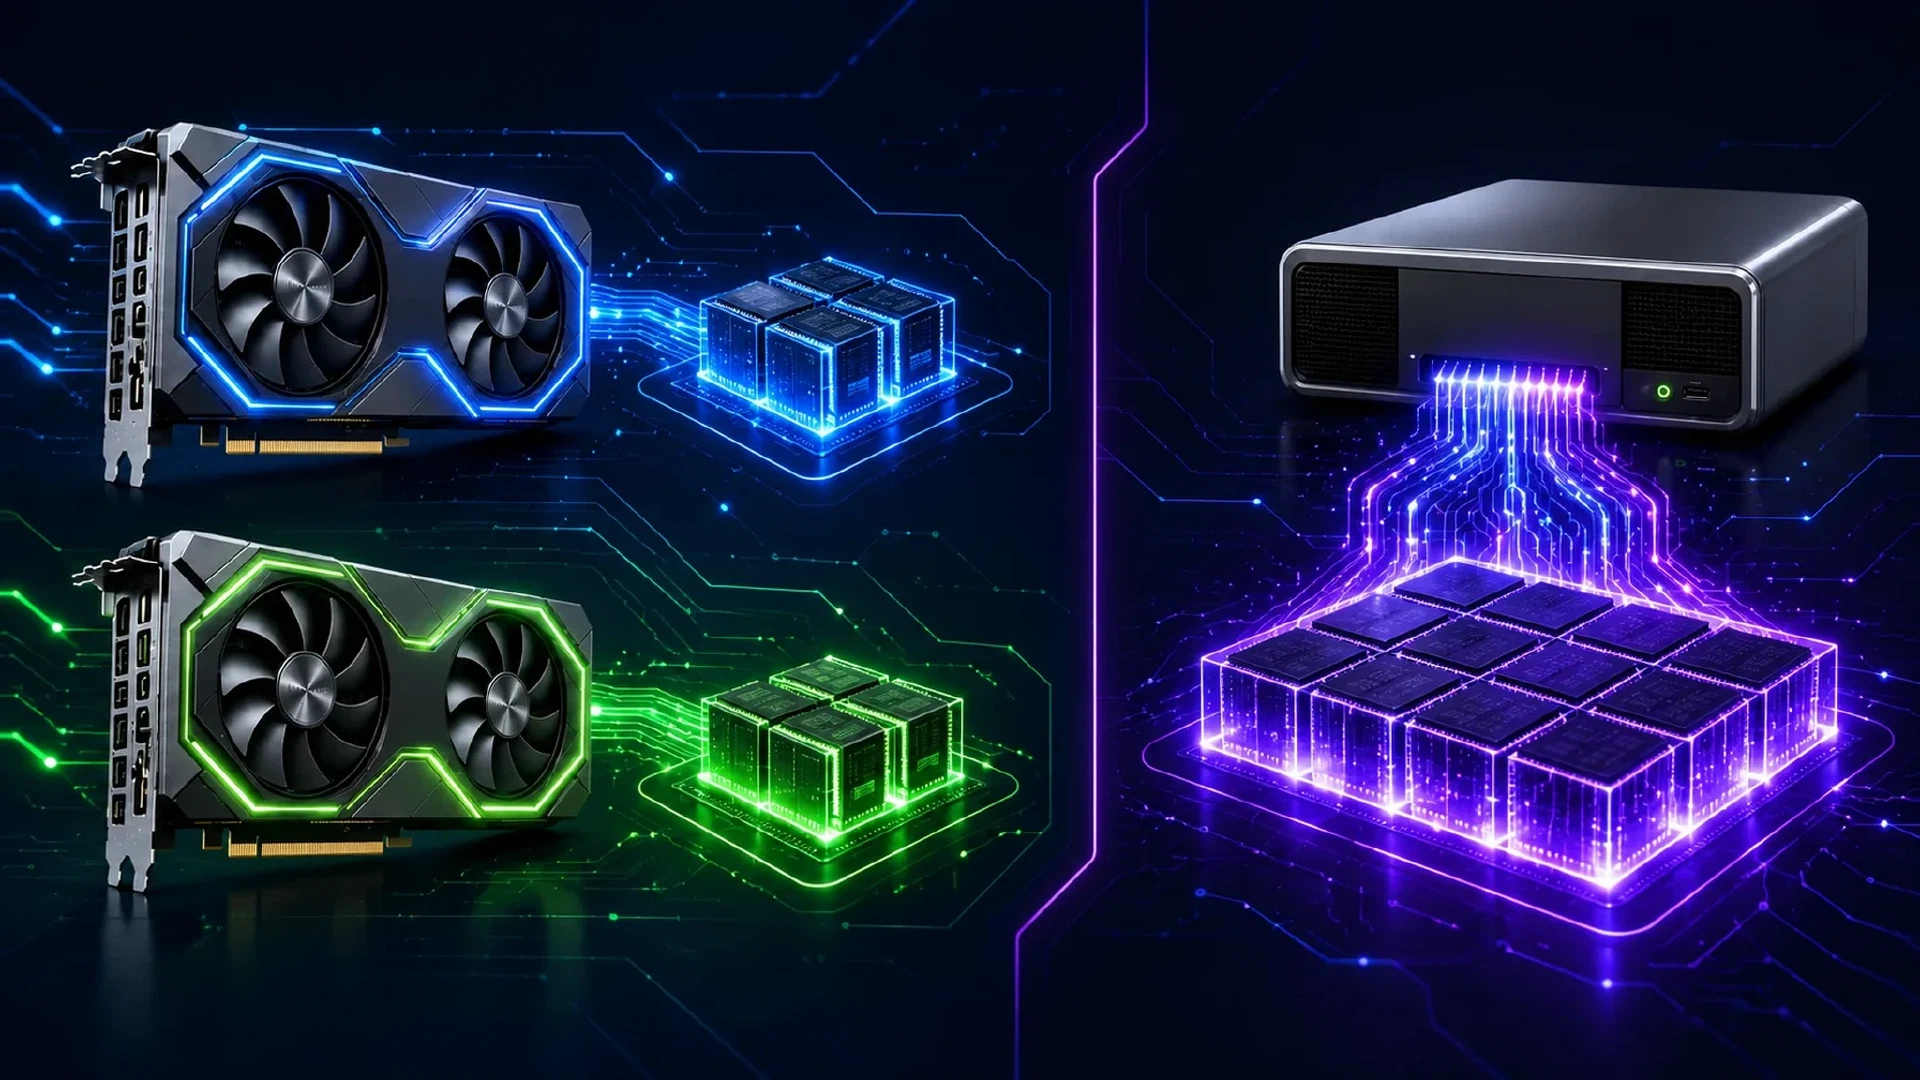
Table of Contents
16 GB वाले दो RTX 5060 Ti कार्ड पार्ट्स की सूची में अच्छे लगते हैं। वे कुल 32 GB VRAM और छोटे संदर्भ के prompt processing की अच्छी गति देते हैं। 27B मॉडल को लंबे संदर्भ के साथ चलाने पर तुलना बदल जाती है।
NVIDIA GB10 सिस्टम 128 GB coherent unified memory इस्तेमाल करता है। NVIDIA GB10 प्लेटफॉर्म के लिए 128 GB LPDDR5x unified memory और 140 W chip TDP बताता है। RTX 5060 Ti में हर कार्ड पर 16 GB GDDR7, 128-bit memory interface और 180 W total graphics power है। NVIDIA RTX 5060 Ti specifications और NVIDIA GB10 specifications हार्डवेयर का अंतर स्पष्ट करते हैं।
मुख्य बात सरल है। दो 16 GB कार्ड एक तेज 32 GB memory pool नहीं बनाते। वे host system से जुड़े दो अलग 16 GB pools बनाते हैं। बड़े मॉडल के inference में missing capacity और devices के बीच data movement, कार्डों की संख्या से अधिक महत्वपूर्ण होते हैं।
मेमोरी की तुलना
| सिस्टम | मेमोरी | मेमोरी मॉडल | बताई गई power figure |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB कुल | दो अलग GPU memory pools | 360 W GPU कुल |
| GB10 सिस्टम | 128 GB | coherent unified system memory | 140 W GB10 TDP |
GB10 इसलिए नहीं जीतता कि 128 GB LPDDR5x memory high-end discrete GPU की bandwidth के बराबर है। लाभ capacity और placement से आता है। CPU और GPU एक ही address space साझा करते हैं। इसलिए model, runtime buffers, activations और context data को दो अलग 16 GB devices में फिट होने की जरूरत नहीं होती।
दो-कार्ड सिस्टम को placement की कठिन समस्या का सामना करना पड़ता है। मॉडल को दोनों कार्डों में फिट होना चाहिए। Inference runtime को उनके बीच data भेजना पड़ता है। PCIe traffic latency बढ़ाता है और bandwidth इस्तेमाल करता है। NVIDIA specifications के अनुसार RTX 5060 Ti NVLink support भी नहीं करता।
बेंचमार्क का परिणाम
नीचे के परिणाम दिए गए AI benchmark report से आते हैं। Report बिना नाम वाले dual-GPU system, जिसे 5060ti-x2 कहा गया है, की GB10 system से तुलना करती है। Test कई context sizes पर Qwen और GPT-OSS को कवर करता है।
Models सीधे Ollama से आए। Test में literal default tags qwen3.8:27b और gpt-oss:latest इस्तेमाल हुए। कोई custom Modelfile या alternate quantization नहीं चुनी गई। Benchmark के समय 5060ti-x2 system ने PCIe Gen4 x16 और उपलब्ध नवीनतम NVIDIA Linux drivers इस्तेमाल किए।
Qwen prompt processing और generation
| Context | 5060ti-x2 prompt tok/s | 5060ti-x2 generation tok/s | GB10 prompt tok/s | GB10 generation tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
4K पर dual-card system GB10 से करीब दो गुना तेज generation करता है। 64K पर यह बढ़त करीब 1.5 गुना रह जाती है। 128K पर दोनों systems लगभग समान generation speed तक पहुंचते हैं।
256K पर दो-कार्ड build की बढ़त समाप्त हो जाती है। 5060ti-x2 request केवल 171,359 actual prompt tokens तक पहुंची। Generation 1.2 tokens per second तक गिर गई। GB10 ने पूरा 256K test 25.8 tokens per second पर पूरा किया।
Test किए गए 256K result में GB10 ने करीब 21.5 गुना तेज generation की। इससे भी महत्वपूर्ण बात यह है कि GB10 ने requested context पूरा किया। Dual-card system ने वही workload पूरा नहीं किया।
Aggregate VRAM भ्रामक क्यों है
1. मॉडल को एक 32 GB कार्ड दिखाई नहीं देता
दो GPUs अपनी memory को एक local address space में merge नहीं करते। Model-parallel runtime layers या tensors को devices में बांटता है। हर device को अपने assigned weights, temporary buffers और context state के हिस्से के लिए जगह चाहिए।
इसलिए usable capacity साधारण sum से कम होती है। Exact overhead model format, quantization, inference backend, tensor split और context length पर निर्भर करता है।
2. Generation के दौरान context memory बढ़ती है
Model weights memory budget का केवल एक हिस्सा हैं। Key-value cache, या KV cache, पिछले tokens का attention data रखता है। लंबे contexts को अधिक cache memory चाहिए। 4K test, 128K या 256K deployment का अनुमान नहीं देता।
दिए गए results यह सीमा साफ दिखाते हैं। Dual-card system prompt processing में मजबूत बढ़त रखता है, फिर context बढ़ने पर generation performance खोता है। GB10, 4K से 256K तक करीब 26 से 29 generation tokens per second पर रहता है।
3. PCIe transfers अतिरिक्त लागत जोड़ते हैं
जब runtime GPUs के बीच activations या tensors भेजता है, transfer host interconnect से गुजरता है। इससे हर step में synchronization points और latency जुड़ती है। Workload के device boundary पार करने की आवृत्ति बढ़ने पर penalty भी बढ़ती है।
इससे dual-GPU system बेकार नहीं हो जाता। Memory placement performance result का हिस्सा है। केवल 4K prompt processing report करने वाला benchmark यह cost नहीं दिखाता।
4. Power efficiency पूरे system का लाभ है
तुलना में GB10 कम power इस्तेमाल करता है और tested long-context workload के लिए अधिक memory capacity देता है। दो RTX 5060 Ti बाकी system से पहले कुल 360 W GPU power लेते हैं। NVIDIA GB10 TDP 140 W बताता है।
GB10 short-context की peak speed के बदले capacity, completion और कम GPU power देता है। Long-context Qwen inference में यह trade-off महत्वपूर्ण है।
5060ti-x2 system की लागत बहुत कम है
Performance comparison price difference को समाप्त नहीं करता। दो 16 GB RTX 5060 Ti वाली complete workstation 10 October 2026 को $3,479 पर listed थी। Configuration में Intel Ultra 7 265K, Z890 motherboard, 32 GB DDR5, 1 TB storage, 1,000 W power supply और दोनों GPUs शामिल हैं। Complete dual-GPU workstation listing देखें ।
NVIDIA US marketplace 128 GB DGX Spark को $6,950 पर list करता है। Listing में 128 GB coherent unified memory और 4 TB NVMe storage शामिल है, लेकिन system out of stock दिखता है। NVIDIA की current DGX Spark listing देखें ।
AMD Ryzen AI Halo Developer Platform एक और comparison point देता है। यह Strix Halo system Micro Center पर $3,999.99 में 128 GB LPDDR5x unified memory और 2 TB storage के साथ listed है। Strix Halo अक्सर GB10 systems जैसी practical local-AI class में आता है, हालांकि independent testing throughput और software maturity में GB10 को अक्सर आगे मापती है। Current Micro Center Linux listing देखें और Strix Halo versus GB10 review पढ़ें ।
| Complete system | 10 October 2026 को listed price | Price difference |
|---|---|---|
| 5060ti-x2 workstation | $3,479 | Baseline |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 अधिक |
| 128 GB GB10 DGX Spark | $6,950 | $3,471 अधिक |
GB10 बड़ा unified memory pool, कम power use और long-context के लिए बेहतर architecture देता है। AMD system करीब $4,000 में वही 128 GB memory class देता है। 5060ti-x2 workstation listed GB10 price का लगभग 50% रहता है, tax और shipping से पहले। जिन buyers को unified memory चाहिए, लेकिन NVIDIA software stack नहीं चाहिए, उनके लिए Strix Halo कम लागत वाला विकल्प है।
ये अलग vendors की listed prices हैं, controlled retail basket नहीं। Comparison में 5060ti-x2 system में कम system memory और storage भी है। Price gap फिर भी महत्वपूर्ण है, क्योंकि दोनों listings complete usable computers की हैं, bare GPU prices की नहीं। Current RTX 5060 Ti 16 GB card listings करीब $789 से $830 प्रति card हैं, जो $429 launch MSRP से बहुत अधिक है। Current GPU price spike में भी dual-card price advantage बना रहता है। Current RTX 5060 Ti price checks देखें ।
GPT-OSS result को अलग तरह से देखें
वही report 4K से 256K तक GPT-OSS के लिए मजबूत 5060ti-x2 generation results दिखाती है। GB10 4K से 128K tests पूरा करता है, लेकिन 256K GPT-OSS test unsupported marked है।
GPT-OSS table से universal winner का दावा न करें। 256K पर tests समान range cover नहीं करते। Qwen result long-context comparison के लिए साफ है, क्योंकि दोनों systems 256K result report करते हैं, भले ही 5060ti-x2 run केवल 171,359 actual prompt tokens तक पहुंची हो।
Qwen 3 27B build के लिए इसका अर्थ
दो 16 GB cards वाला setup छोटे context में quantized 27B model चला सकता है। Benchmark ऐसे use case को खारिज नहीं करता। Data इस दावे को खारिज करते हैं कि 32 GB aggregate VRAM, 128 GB unified-memory system जितनी practical headroom देती है।
किसी card पर model fit होना केवल weight capacity साबित करता है। असली memory requirement में model weights, active context, KV cache, runtime buffers और operating-system headroom शामिल हैं। Context को model के साथ fit होना चाहिए। Load होने वाला ऐसा model जिसमें working conversation के लिए जगह नहीं है, usable long-context setup नहीं है।
यह sizing guidance in Is 16GB VRAM Enough for Serious Local LLM Work? से मेल खाता है, जो weights, context और runtime allocations को एक budget मानती है। 32GB VRAM guide for Qwen 27B two-card builds के लिए यही conclusion देती है। Aggregate capacity usable headroom के बराबर नहीं है।
Hardware खरीदने से पहले Qwen 3 27B deployment के लिए चार प्रश्न पूछें:
- क्या requested quantization runtime buffers के साथ fit होती है? केवल model weights memory requirement तय नहीं करते।
- क्या context severe KV-cache pressure के बिना fit होता है? Long prompts result बदलते हैं।
- क्या runtime fast device split इस्तेमाल करता है? PCIe transfers और tensor placement हर generated token को प्रभावित करते हैं।
- क्या system target context पूरा करता है? Fast 4K result failed 256K workload की भरपाई नहीं करता।
Supplied test dual-card system के लिए आखिरी प्रश्न का उत्तर देता है। Run 256K Qwen request में 171,359 tokens तक पहुंची और 1.2 tokens per second पर generate हुई। GB10 ने 256K को 25.8 tokens per second पर पूरा किया।
इस long-context workload के लिए unified memory बेहतर architecture है, जब alternative model के working set को PCIe के सहारे फैलाता है। PCIe capacity workaround है। PCIe वही memory pool, latency या transfer path नहीं बनाता। Local AI GPU context guide बताती है कि model weights, KV cache, tool output और runtime buffers को साथ में size करना चाहिए। Ollama Qwen3.8 27B GPU benchmark भी दिखाता है कि long-context results को short-context decode numbers से अलग देखना चाहिए।
निष्कर्ष
Long-context 27B inference के लक्ष्य में दो 16 GB RTX 5060 Ti cards GB10 का कमजोर विकल्प हैं। वे छोटे context sizes पर अधिक prompt throughput देते हैं। वे अधिक GPU power लेते हैं और runtime को split-memory layout में चलाते हैं।
Supplied results में GB10 prompt processing में धीमा है। System अधिक power efficient है, चार गुना aggregate memory देता है और पूरा 256K Qwen test usable generation speed पर पूरा करता है।
यदि आप short prompts चलाते हैं और prompt ingestion को प्राथमिकता देते हैं, तो 5060ti-x2 का सीमित use case है। 27B model के लिए बड़ा unified memory pool बेहतर है, क्योंकि model और context एक coherent working set साझा करते हैं। PCIe transfers inference path में आने पर unified memory बेहतर रहती है।
Benchmark यह नहीं दिखाता कि दो RTX 5060 Ti कभी Qwen 3 27B शुरू नहीं करेंगे। Data दिखाते हैं कि model शुरू करना और workload को अच्छी तरह चलाना अलग बातें हैं।
Benchmark की सीमाएं
Supplied report literal Ollama tags पहचानती है, लेकिन resolved manifest digests, model revisions, CPU, power measurements या cooling setup दर्ज नहीं करती। Report 5060ti-x2 system के लिए PCIe Gen4 x16 और test के समय current NVIDIA Linux drivers भी पहचानती है। Figures को observed system comparison मानें, हर RTX 5060 Ti pair और हर GB10 implementation की universal ranking नहीं।
ऊपर की hardware specifications NVIDIA से आती हैं। Performance figures इस article के लिए supplied benchmark data से आती हैं।
References
- Ollama Qwen3.8 model library
- Ollama GPT-OSS model tags
- क्या गंभीर स्थानीय LLM कार्य के लिए 16GB VRAM पर्याप्त है?
- Qwen 27B के लिए 32GB VRAM
- स्थानीय AI GPU संदर्भ गाइड
- Vast.ai पर Qwen3.8 27B GPU benchmarks
- दो RTX 5060 Ti 16 GB वाली complete workstation listing
- NVIDIA DGX Spark US marketplace listing
- AMD Ryzen AI Halo 128 GB Linux listing
- Tom’s Hardware Strix Halo बनाम GB10 review
- RTX 5060 Ti की वर्तमान कीमतें
Related Posts